# ViTMatte
## Genel Bakış
ViTMatte modeli, Jingfeng Yao, Xinggang Wang, Shusheng Yang ve Baoyuan Wang tarafından [Boosting Image Matting with Pretrained Plain Vision Transformers](https://huggingface.co/papers/2305.15272) makalesinde önerilmiştir. ViTMatte, görüntü ve videolardaki ön plan nesnesini doğru bir şekilde tahmin etme süreci olan görüntü matting görevi için düz [Vision Transformers](vit) kullanır.
Makalenin özeti aşağıdaki gibidir:
*Son zamanlarda, düz görü Transformer'ları (ViT), güçlü modelleme kapasiteleri ve büyük ölçekli ön eğitimi sayesinde çeşitli bilgisayarla görme görevlerinde etkileyici performanslar sergilemiştir. Ancak henüz görüntü matting (matting) sorununu çözmüş değillerdir. Görüntü matting'inin de ViT'ler tarafından iyileştirilebileceğini varsayıyor ve ViTMatte adını verdiğimiz yeni, verimli ve sağlam ViT tabanlı bir matting sistemi sunuyoruz. Yöntemimiz, (i) matting görevlerinde ViT'lerin mükemmel bir performans-hesaplama ödünleşimi elde etmesine yardımcı olmak için bir konvolüsyon boyun (neck) ile birleştirilmiş hibrit bir dikkat mekanizmasını kullanır. (ii) Ayrıca, matting'in gerektirdiği ayrıntılı bilgiyi tamamlamak için yalnızca basit ve hafif konvolüsyonlardan oluşan ayrıntı yakalama modülünü tanıtıyoruz. Bildiğimiz kadarıyla ViTMatte, ViT'nin potansiyelini görüntü matting'de sade bir uyarlama ile ortaya çıkaran ilk çalışmadır. ViT'nin matting'e birçok üstün özelliğini devralır; bunlar arasında çeşitli ön eğitim stratejileri, sade mimari tasarım ve esnek çıkarım (inference) stratejileri yer alır. ViTMatte'yi, görüntü matting için en yaygın kullanılan referans setleri olan Composition-1k ve Distinctions-646 üzerinde değerlendiriyoruz; yöntemimiz en iyi performansı (state-of-the-art) elde ediyor ve önceki matting çalışmalarını büyük bir farkla geride bırakıyor.*
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/hustvl/ViTMatte) bulunabilir.
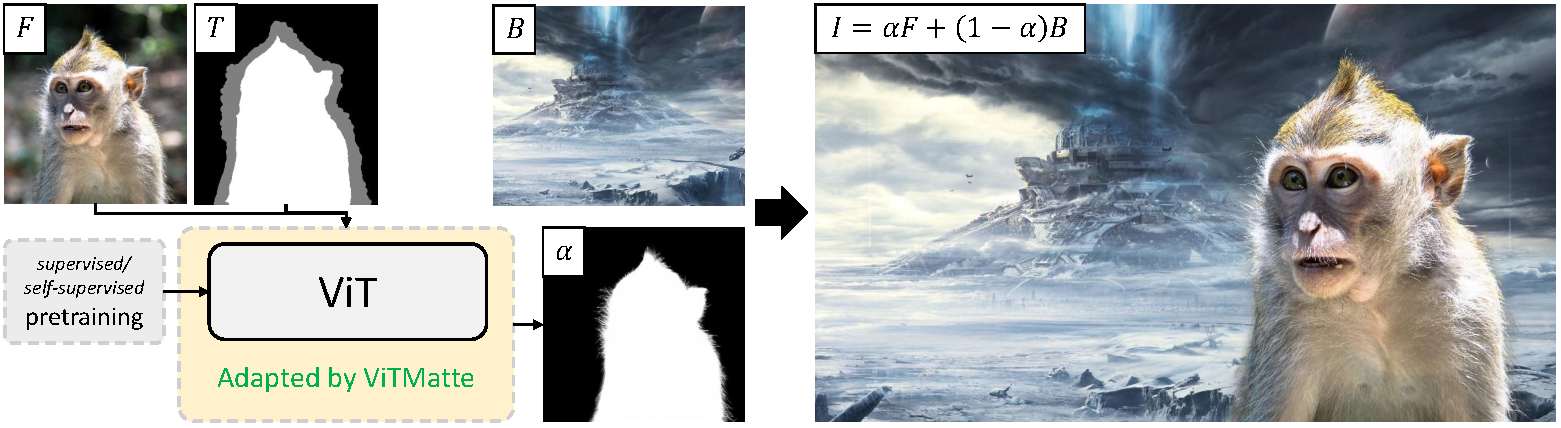 ViTMatte yüksek düzeyde genel bakış. Orijinal makaleden alınmıştır.
## Kaynaklar
ViTMatte ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- [VitMatteForImageMatting](/docs/transformers/main/tr/model_doc/vitmatte#transformers.VitMatteForImageMatting) ile çıkarım hakkında, arka plan değiştirme dahil olmak üzere bir demo defterine [buradan](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViTMatte) ulaşabilirsiniz.
Model, hem görüntüyü hem de trimap'i (birleştirilmiş) girdi olarak bekler. Bu amaç için `ViTMatteImageProcessor` kullanın.
## VitMatteConfig[[transformers.VitMatteConfig]]
#### transformers.VitMatteConfig[[transformers.VitMatteConfig]]
```python
transformers.VitMatteConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, hidden_size: int = 384, batch_norm_eps: float = 1e-05, initializer_range: float = 0.02, convstream_hidden_sizes: list[int] | tuple[int, ...] = (48, 96, 192), fusion_hidden_sizes: list[int] | tuple[int, ...] = (256, 128, 64, 32))
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/configuration_vitmatte.py#L25)
**Parametreler:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Omurga modelinin yapılandırması.
hidden_size (`int`, *isteğe bağlı*, varsayılan `384`) : Gizli temsillerin boyutu.
batch_norm_eps (`float`, *opsiyonel*, varsayılan 1e-05) : Batch norm katmanları tarafından kullanılan epsilon.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
convstream_hidden_sizes (`list[int]`, *isteğe bağlı*, varsayılan `[48, 96, 192]`) : ConvStream modülünün çıktı kanalları.
fusion_hidden_sizes (`list[int]`, *isteğe bağlı*, varsayılan `[256, 128, 64, 32]`) : Fusion bloklarının çıktı kanalları.
Bu, bir VitmatteModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Vitmatte modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, [hustvl/vitmatte-small-composition-1k](https://huggingface.co/hustvl/vitmatte-small-composition-1k) modelinin yapılandırmasına benzer bir yapılandırma üretir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import VitMatteConfig, VitMatteForImageMatting
>>> # Initializing a ViTMatte hustvl/vitmatte-small-composition-1k style configuration
>>> configuration = VitMatteConfig()
>>> # Initializing a model (with random weights) from the hustvl/vitmatte-small-composition-1k style configuration
>>> model = VitMatteForImageMatting(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## VitMatteImageProcessor[[transformers.VitMatteImageProcessor]]
#### transformers.VitMatteImageProcessor[[transformers.VitMatteImageProcessor]]
```python
transformers.VitMatteImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_vitmatte.py#L45)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Görüntünün genişliği ve yüksekliği, bu sayıya bölünebilir olacak şekilde doldurulur.
Bir VitMatteImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.VitMatteImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_vitmatte.py#L87)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
trimaps (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işleme tabi tutulacak trimaplar.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Görüntünün genişliği ve yüksekliği, bu sayıya bölünebilir olacak şekilde doldurulur.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## VitMatteImageProcessorPil[[transformers.VitMatteImageProcessorPil]]
#### transformers.VitMatteImageProcessorPil[[transformers.VitMatteImageProcessorPil]]
```python
transformers.VitMatteImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_pil_vitmatte.py#L44)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Görüntünün genişliği ve yüksekliği, bu sayıya bölünebilir olacak şekilde doldurulur.
Bir VitMatteImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.VitMatteImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], trimaps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/image_processing_pil_vitmatte.py#L89)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
trimaps (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işleme tabi tutulacak trimaplar.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Görüntünün genişliği ve yüksekliği, bu sayıya bölünebilir olacak şekilde doldurulur.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## VitMatteForImageMatting[[transformers.VitMatteForImageMatting]]
#### transformers.VitMatteForImageMatting[[transformers.VitMatteForImageMatting]]
```python
transformers.VitMatteForImageMatting(config: VitMatteConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/modeling_vitmatte.py#L221)
**Parametreler:**
config ([VitMatteConfig](/docs/transformers/main/tr/model_doc/vitmatte#transformers.VitMatteConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
ADE20k, CityScapes gibi veri setleri için herhangi bir görü omurgasını (vision backbone) kullanan ViTMatte çerçevesi.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.VitMatteForImageMatting.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vitmatte/modeling_vitmatte.py#L232)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [VitMatteImageProcessor](/docs/transformers/main/tr/model_doc/vitmatte#transformers.VitMatteImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [VitMatteImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [VitMatteImageProcessor](/docs/transformers/main/tr/model_doc/vitmatte#transformers.VitMatteImageProcessor) kullanır).
output_attentions (`bool`, *isteğe bağlı*) : Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmediğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `attentions` bölümüne bakın.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
labels (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Kayıp (loss) hesaplamak için kullanılan gerçek değer (ground truth) görüntü matting'i.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/main/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
[VitMatteForImageMatting](/docs/transformers/main/tr/model_doc/vitmatte#transformers.VitMatteForImageMatting) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
Örnekler:
```python
>>> from transformers import VitMatteImageProcessor, VitMatteForImageMatting
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> processor = VitMatteImageProcessor.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> model = VitMatteForImageMatting.from_pretrained("hustvl/vitmatte-small-composition-1k")
>>> filepath = hf_hub_download(
... repo_id="hf-internal-testing/image-matting-fixtures", filename="image.png", repo_type="dataset"
... )
>>> image = Image.open(filepath).convert("RGB")
>>> filepath = hf_hub_download(
... repo_id="hf-internal-testing/image-matting-fixtures", filename="trimap.png", repo_type="dataset"
... )
>>> trimap = Image.open(filepath).convert("L")
>>> # prepare image + trimap for the model
>>> inputs = processor(images=image, trimaps=trimap, return_tensors="pt")
>>> with torch.no_grad():
... alphas = model(**inputs).alphas
>>> print(alphas.shape)
torch.Size([1, 1, 640, 960])
```