# Swin2SR
## 개요
Swin2SR 모델은 Marcos V. Conde, Ui-Jin Choi, Maxime Burchi, Radu Timofte가 [Swin2SR: SwinV2 Transformer for Compressed Image Super-Resolution and Restoration](https://huggingface.co/papers/2209.11345)에서 제안했습니다. Swin2SR은 [SwinIR](https://github.com/JingyunLiang/SwinIR/) 모델을 [Swin Transformer v2](swinv2) 레이어를 통합하여 개선했으며, 이를 통해 학습 불안정성, 사전 학습과 미세 조정 간의 해상도 차이, 데이터 의존성 과다와 같은 문제를 완화합니다.
해당 논문의 초록은 다음과 같습니다:
*압축은 스트리밍 서비스, 가상 현실, 비디오 게임과 같은 대역 제한 시스템에서 이미지와 비디오의 효율적인 전송 및 저장에 중요한 역할을 합니다. 그러나 압축은 불가피하게 아티팩트와 원본 정보의 손실을 초래하며, 이는 시각적 품질을 심각하게 저하시킬 수 있습니다. 이러한 이유로 압축된 이미지의 품질 향상은 인기 있는 연구 주제가 되었습니다. 대부분의 최첨단 이미지 복원 방법은 합성 신경망에 기반하지만, SwinIR와 같은 다른 Transformer 기반 방법은 이러한 작업에서 인상적인 성능을 보여줍니다. 이 논문에서는 이미지 초해상도, 특히 압축된 입력 시나리오에 대해 SwinIR를 개선하기 위해 새로운 Swin Transformer V2를 탐구합니다. 이 방법을 사용하면 Transformer 비전 모델 학습의 주요 문제점, 즉 학습 불안정성, 사전 학습과 미세 조정 간의 해상도 차이, 데이터 요구량 문제를 해결할 수 있습니다. 우리는 세 가지 대표적인 작업에 대해 실험을 수행했습니다: JPEG 압축 아티팩트 제거, 이미지 초해상도(클래식 및 경량), 압축 이미지 초해상도. 실험 결과는 우리의 방법인 Swin2SR이 SwinIR의 학습 수렴과 성능을 향상시킬 수 있으며, "AIM 2022 Challenge on Super-Resolution of Compressed Image and Video"에서 상위 5위 솔루션임을 보여줍니다.*
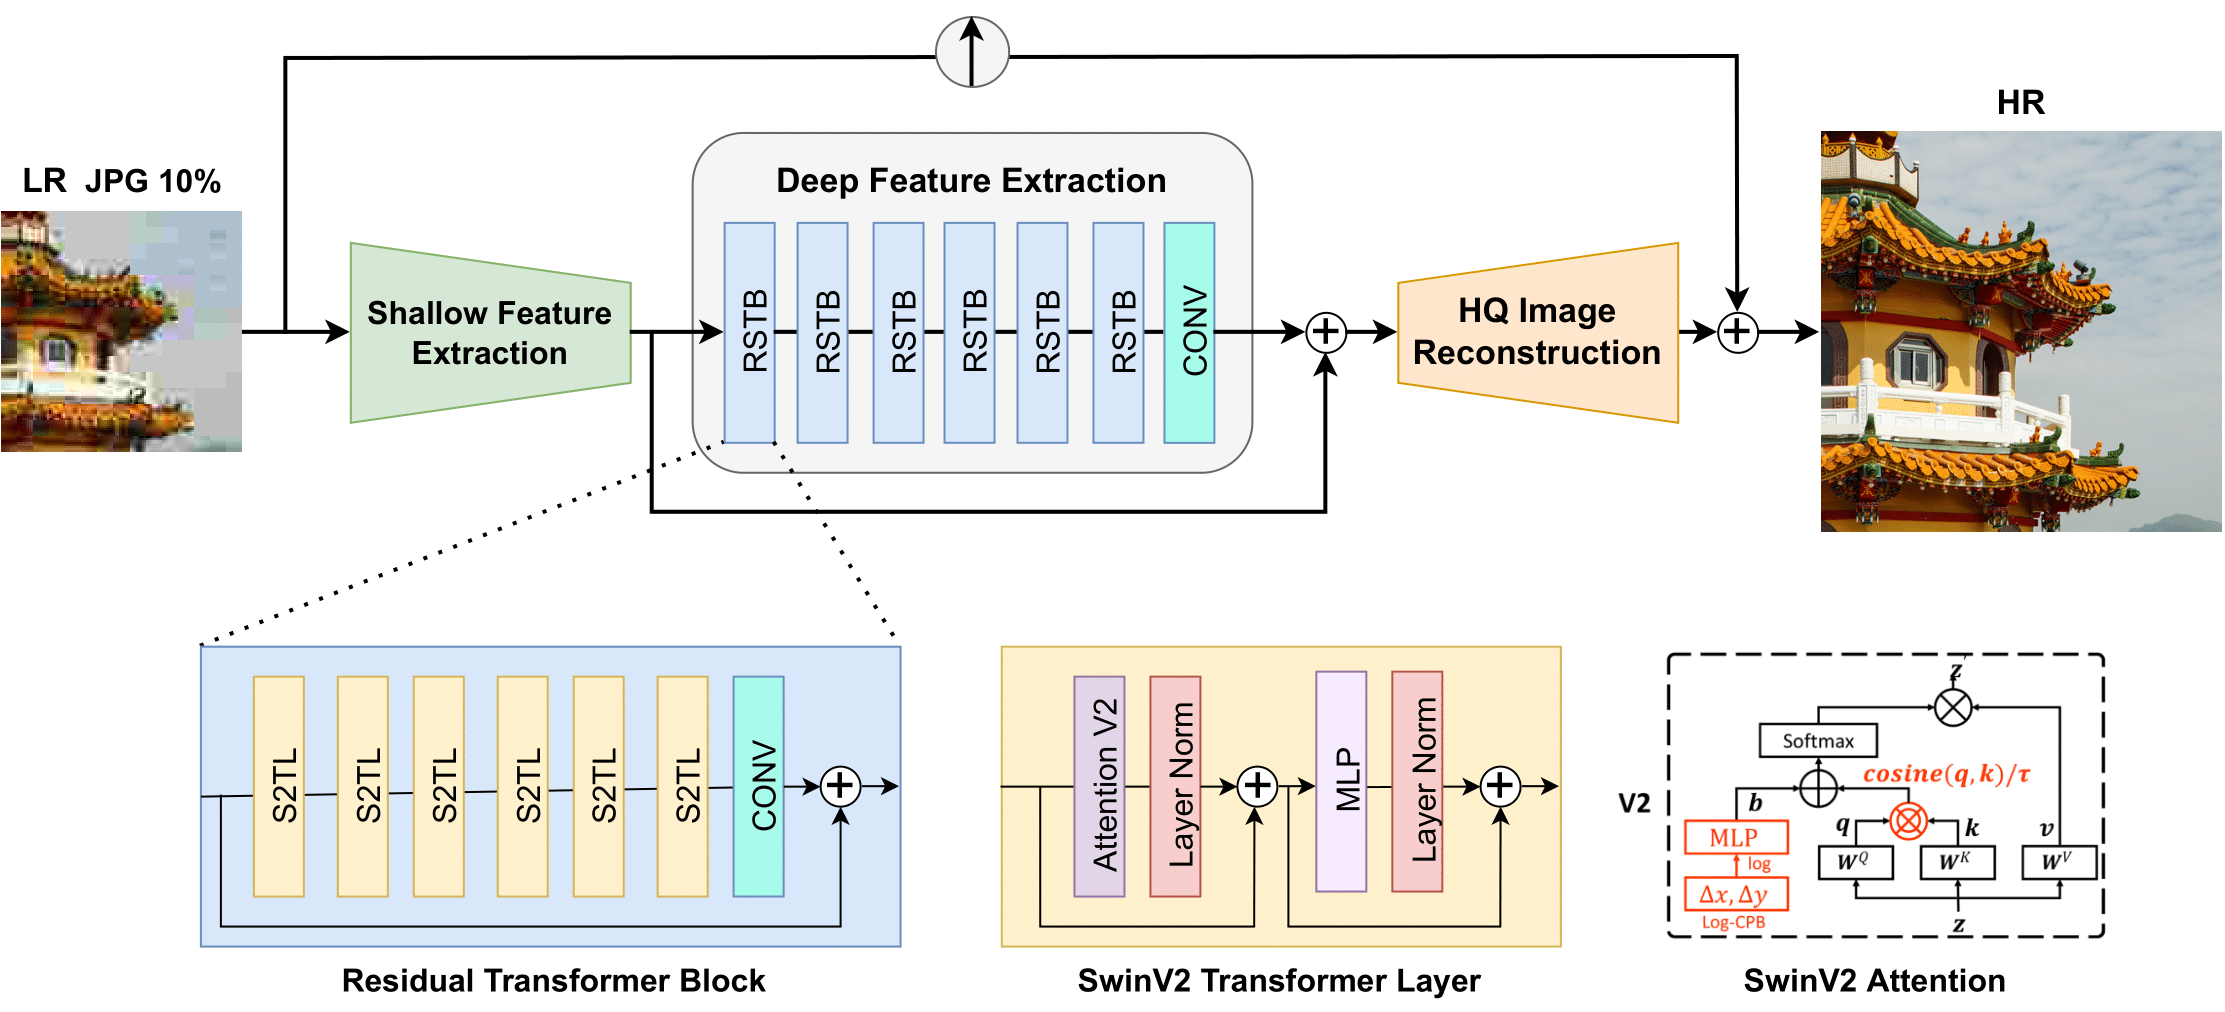 Swin2SR 아키텍처. 원 논문에서 가져왔습니다.
이 모델은 [nielsr](https://huggingface.co/nielsr)에 의해 기여되었습니다. 원본 코드는 [여기](https://github.com/mv-lab/swin2sr)에서 찾을 수 있습니다.
## 리소스
Swin2SR 데모 노트북은 [여기](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Swin2SR)에서 찾을 수 있습니다.
SwinSR를 사용한 이미지 초해상도 데모 Space를 [여기](https://huggingface.co/spaces/jjourney1125/swin2sr)에서 확인할 수 있습니다.
## Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
#### transformers.Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
```python
transformers.Swin2SRImageProcessor(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_swin2sr.py#L41)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
size_divisor (`int`, *kwargs*, *선택 사항*, 기본값은 `self.size_divisor`) : 패딩 시 높이와 너비가 나뉘도록 할 크기입니다.
Swin2SRImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.Swin2SRImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_swin2sr.py#L58)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
size_divisor (`int`, *kwargs*, *선택 사항*, 기본값은 `self.size_divisor`) : 패딩 시 높이와 너비가 나뉘도록 할 크기입니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
#### transformers.Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
```python
transformers.Swin2SRImageProcessorPil(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L42)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
size_divisor (`int`, *kwargs*, *선택 사항*, 기본값은 `self.size_divisor`) : 패딩 시 높이와 너비가 나뉘도록 할 크기입니다.
Swin2SRImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.Swin2SRImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L59)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
size_divisor (`int`, *kwargs*, *선택 사항*, 기본값은 `self.size_divisor`) : 패딩 시 높이와 너비가 나뉘도록 할 크기입니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## Swin2SRConfig[[transformers.Swin2SRConfig]]
#### transformers.Swin2SRConfig[[transformers.Swin2SRConfig]]
```python
transformers.Swin2SRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 64, patch_size: int | list[int] | tuple[int, int] = 1, num_channels: int = 3, num_channels_out: int | None = None, embed_dim: int = 180, depths: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), num_heads: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), window_size: int = 8, mlp_ratio: float = 2.0, qkv_bias: bool = True, hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, drop_path_rate: float | int = 0.1, hidden_act: str = 'gelu', use_absolute_embeddings: bool = False, initializer_range: float = 0.02, layer_norm_eps: float = 1e-05, upscale: int = 2, img_range: float = 1.0, resi_connection: str = '1conv', upsampler: str = 'pixelshuffle')
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/configuration_swin2sr.py#L24)
**매개변수:**
image_size (`Union[int, list[int], tuple[int, int]]`, *선택 사항*, 기본값 `64`) : 각 이미지의 크기(해상도).
patch_size (`Union[int, list[int], tuple[int, int]]`, *선택 사항*, 기본값 `1`) : 각 패치의 크기(해상도).
num_channels (`int`, *선택 사항*, 기본값 `3`) : 입력 채널의 수입니다.
num_channels_out (`int`, *선택 사항*, 기본값 `num_channels`) : 출력 채널의 수입니다. 설정하지 않으면 `num_channels`로 설정됩니다.
embed_dim (`int`, *선택 사항*, 기본값 `180`) : 임베딩 및 숨겨진 상태의 차원.
depths (`list(int)`, *선택 사항*, 기본값 `[6, 6, 6, 6, 6, 6]`) : Transformer 인코더의 각 레이어 깊이.
num_heads (`list(int)`, *선택 사항*, 기본값 `[6, 6, 6, 6, 6, 6]`) : Transformer 인코더의 각 레이어에 있는 어텐션 헤드 수입니다.
window_size (`int`, *선택 사항*, 기본값 8) : 윈도우의 크기.
mlp_ratio (`float`, *선택 사항*, 기본값 `2.0`) : MLP 숨겨진 차원과 임베딩 차원의 비율입니다.
qkv_bias (`bool`, *선택 사항*, 기본값 `True`) : 쿼리, 키, 값에 bias를 추가할지 여부.
hidden_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : 임베딩, 인코더, 풀러의 모든 완전 연결 계층에 적용되는 dropout 확률입니다.
attention_probs_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : attention 확률에 적용할 dropout 비율입니다.
drop_path_rate (`Union[float, int]`, *선택 사항*, 기본값 `0.1`) : 패치 퓨전(drop path)에 사용할 드롭 패스 비율입니다.
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
use_absolute_embeddings (`bool`, *선택 사항*, 기본값 `False`) : 절대 위치 임베딩을 사용할지 여부.
initializer_range (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-05`) : layer normalization 레이어에서 사용되는 epsilon 값입니다.
upscale (`int`, *선택 사항*, 기본값 2) : 이미지의 업스케일링 배율입니다. 이미지 초해상도에는 2/3/4/8, 노이즈 제거 및 압축 아티팩트 감소에는 1을 사용합니다.
img_range (`float`, *선택 사항*, 기본값 1.0) : 입력 이미지의 값 범위입니다.
resi_connection (`str`, *선택 사항*, 기본값 `"1conv"`) : 각 단계에서 잔차 연결(residual connection) 전에 사용할 컨볼루션 블록입니다.
upsampler (`str`, *선택 사항*, 기본값 `"pixelshuffle"`) : 재구성 모듈입니다. 'pixelshuffle'/'pixelshuffledirect'/'nearest+conv'/None 중 하나를 사용할 수 있습니다.
이것은 Swin2SRModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Swin2Sr 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [caidas/swin2sr-classicalsr-x2-64](https://huggingface.co/caidas/swin2sr-classicalsr-x2-64)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import Swin2SRConfig, Swin2SRModel
>>> # Initializing a Swin2SR caidas/swin2sr-classicalsr-x2-64 style configuration
>>> configuration = Swin2SRConfig()
>>> # Initializing a model (with random weights) from the caidas/swin2sr-classicalsr-x2-64 style configuration
>>> model = Swin2SRModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Swin2SRModel[[transformers.Swin2SRModel]]
#### transformers.Swin2SRModel[[transformers.Swin2SRModel]]
```python
transformers.Swin2SRModel(config: Swin2SRConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L710)
**매개변수:**
config ([Swin2SRConfig](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
특정 헤드가 위에 없는 상태에서 원시 hidden-states를 출력하는 기본 Swin2Sr Model입니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Swin2SRModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L752)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [Swin2SRImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [Swin2SRImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 (`processor_class`는 이미지 처리에 [Swin2SRImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRImageProcessor)를 사용합니다).
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** [BaseModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutput) 또는 `tuple(torch.Tensor)`
구성([Swin2SRConfig](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRConfig))과 입력에 따라 다양한 요소를 포함하는 [BaseModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.modeling_outputs.BaseModelOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[Swin2SRModel](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
```
## Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
#### transformers.Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
```python
transformers.Swin2SRForImageSuperResolution(config: Swin2SRConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L943)
**매개변수:**
config ([Swin2SRConfig](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
이미지 초해상도 및 복원을 위해 상단에 업샘플러 헤드가 있는 Swin2SR 모델 transformer입니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.Swin2SRForImageSuperResolution.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L970)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [Swin2SRImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [Swin2SRImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 (`processor_class`는 이미지 처리에 [Swin2SRImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRImageProcessor)를 사용합니다).
labels (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : masked language modeling loss를 계산하기 위한 라벨. 인덱스는 `[0, ..., config.vocab_size]` 범위 내이거나 -100이어야 합니다(`input_ids` docstring 참조). 인덱스가 `-100`으로 설정된 토큰은 무시(마스크)되며, loss는 `[0, ..., config.vocab_size]` 범위의 라벨을 가진 토큰에 대해서만 계산됩니다.
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** `ImageSuperResolutionOutput` 또는 `tuple(torch.Tensor)`
`ImageSuperResolutionOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우)로, [Swin2SRConfig](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRConfig) 및 입력에 따라 다양한 요소를 포함합니다.
[Swin2SRForImageSuperResolution](/docs/transformers/v5.23.0/ko/model_doc/swin2sr#transformers.Swin2SRForImageSuperResolution)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택 사항*, `labels`이 제공될 때 반환됨) -- 재구성 손실.
- **reconstruction** (`torch.Tensor`, shape `(batch_size, num_channels, height, width)`) -- 재구성된 이미지, 업스케일링이 적용되었을 수 있습니다.
- **hidden_states** (`tuple(torch.Tensor)`, *선택*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 단계 출력용 1개)로, shape이 `(batch_size, sequence_length, hidden_size)`입니다. 각 단계 출력 시점의 모델 hidden-states(또는 feature maps)입니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환) -- 각 레이어당 하나씩, shape가 `(batch_size, num_heads, patch_size, sequence_length)`인 `torch.Tensor`의 튜플.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>> from io import BytesIO
>>> from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution
>>> processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> url = "https://huggingface.co/spaces/jjourney1125/swin2sr/resolve/main/samples/butterfly.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # prepare image for the model
>>> inputs = processor(image, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> output = outputs.reconstruction.data.squeeze().float().cpu().clamp_(0, 1).numpy()
>>> output = np.moveaxis(output, source=0, destination=-1)
>>> output = (output * 255.0).round().astype(np.uint8) # float32 to uint8
>>> # you can visualize `output` with `Image.fromarray`
```