# Swin2SR
## Genel Bakış
Swin2SR modeli, Marcos V. Conde, Ui-Jin Choi, Maxime Burchi ve Radu Timofte tarafından [Swin2SR: SwinV2 Transformer for Compressed Image Super-Resolution and Restoration](https://huggingface.co/papers/2209.11345) makalesinde önerilmiştir. Swin2SR, eğitim instabilitesi, ön eğitim ile ince ayar arasındaki çözünürlük farkları ve veriye olan yüksek ihtiyaç gibi sorunları hafifleten [Swin Transformer v2](swinv2) katmanlarını entegre ederek [SwinIR](https://github.com/JingyunLiang/SwinIR/) modelini iyileştirir.
Makalenin özeti aşağıdaki gibidir:
*Sıkıştırma, akış hizmetleri, sanal gerçeklik veya video oyunları gibi bant sınırlı sistemler üzerinden görüntü ve videoların verimli iletimi ve depolanmasında önemli bir rol oynar. Ancak sıkıştırma kaçınılmaz olarak artefaktlara ve orijinal bilginin kaybına yol açar; bu durum görsel kaliteyi ciddi şekilde düşürebilir. Bu nedenlerden ötürü, sıkıştırılmış görüntülerin kalite iyileştirilmesi popüler bir araştırma konusu haline gelmiştir. En son görüntü restorasyon yöntemlerinin çoğu konvolüsyonel sinir ağlarına dayanırken, SwinIR gibi diğer transformer tabanlı yöntemler bu görevlerde etkileyici performans sergilemektedir. Bu makalede, görüntü süper çözünürlüğü için ve özellikle sıkıştırılmış giriş senaryosu için SwinIR'i geliştirmek amacıyla yeni Swin Transformer V2'yi inceliyoruz. Bu yöntemle, transformer görme modellerinin eğitimindeki temel sorunları, örneğin eğitim instabilitesi, ön eğitim ve ince ayar arasındaki çözünürlük farkları ve veri açlığı gibi konuları ele alabiliyoruz. Üç temsilci görev üzerinde deneyler gerçekleştiriyoruz: JPEG sıkıştırma artefaktlarının giderilmesi, görüntü süper çözünürlüğü (klasik ve hafif) ve sıkıştırılmış görüntü süper çözünürlüğü. Deneysel sonuçlar, Swin2SR olarak adlandırdığımız yöntemin SwinIR'in eğitim yakınsamasını ve performansını iyileştirebildiğini ve "AIM 2022 Challenge on Super-Resolution of Compressed Image and Video" yarışmasında ilk 5 çözümden biri olduğunu göstermektedir.*
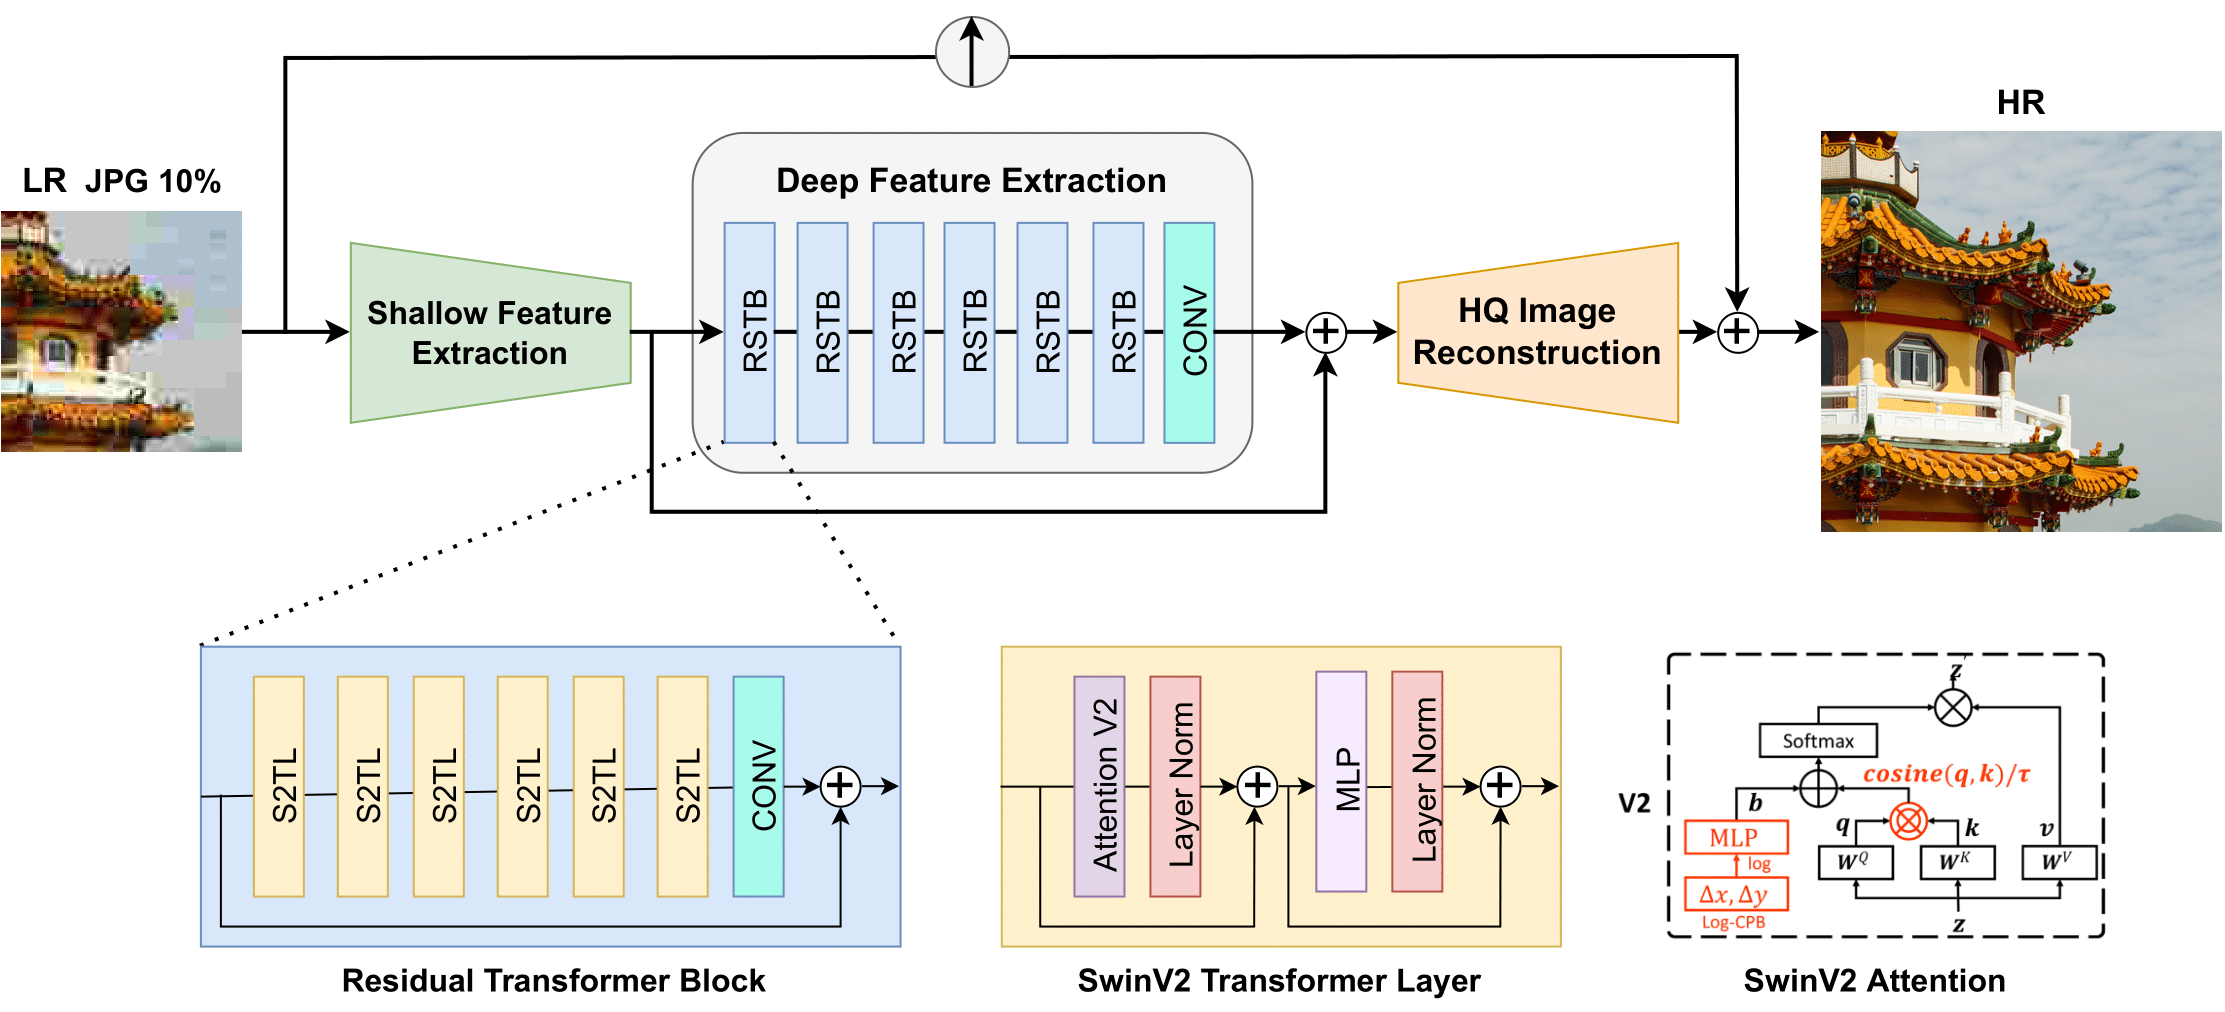 Swin2SR mimarisi. Orijinal makaleden alınmıştır.
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/mv-lab/swin2sr) bulunabilir.
## Kaynaklar
Swin2SR için demo defterlerine [buradan](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Swin2SR) ulaşabilirsiniz.
SwinSR ile görüntü süper çözünürlüğü için bir demo Space [burada](https://huggingface.co/spaces/jjourney1125/swin2sr) bulunabilir.
## Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
#### transformers.Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
```python
transformers.Swin2SRImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_swin2sr.py#L41)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Dolgu sırasında yüksekliğin ve genişliğin bölünebilir olması için kullanılan boyut.
Swin2SRImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.Swin2SRImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_swin2sr.py#L58)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Dolgu sırasında yüksekliğin ve genişliğin bölünebilir olması için kullanılan boyut.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
#### transformers.Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
```python
transformers.Swin2SRImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L42)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Dolgu sırasında yüksekliğin ve genişliğin bölünebilir olması için kullanılan boyut.
Swin2SRImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.Swin2SRImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L59)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, *opsiyonel*, varsayılan `self.size_divisor`) : Dolgu sırasında yüksekliğin ve genişliğin bölünebilir olması için kullanılan boyut.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## Swin2SRConfig[[transformers.Swin2SRConfig]]
#### transformers.Swin2SRConfig[[transformers.Swin2SRConfig]]
```python
transformers.Swin2SRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 64, patch_size: int | list[int] | tuple[int, int] = 1, num_channels: int = 3, num_channels_out: int | None = None, embed_dim: int = 180, depths: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), num_heads: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), window_size: int = 8, mlp_ratio: float = 2.0, qkv_bias: bool = True, hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, drop_path_rate: float | int = 0.1, hidden_act: str = 'gelu', use_absolute_embeddings: bool = False, initializer_range: float = 0.02, layer_norm_eps: float = 1e-05, upscale: int = 2, img_range: float = 1.0, resi_connection: str = '1conv', upsampler: str = 'pixelshuffle')
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/configuration_swin2sr.py#L24)
**Parametreler:**
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `64`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `1`) : Her yamanın boyutu (çözünürlüğü).
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
num_channels_out (`int`, *isteğe bağlı*, varsayılan `num_channels`) : Çıkış kanal sayısı. Ayarlanmazsa `num_channels` olarak ayarlanır.
embed_dim (`int`, *isteğe bağlı*, varsayılan `180`) : Gömme ve gizli durumların boyutluluğu.
depths (`list(int)`, *isteğe bağlı*, varsayılan `[6, 6, 6, 6, 6, 6]`) : Transformer kodlayıcısındaki her katmanın derinliği.
num_heads (`list(int)`, *isteğe bağlı*, varsayılan `[6, 6, 6, 6, 6, 6]`) : Transformer kodlayıcısının her katmanındaki dikkat başlarının sayısı.
window_size (`int`, *isteğe bağlı*, varsayılan 8) : Pencerelerin boyutu.
mlp_ratio (`float`, *isteğe bağlı*, varsayılan `2.0`) : MLP gizli boyutunun gömme boyutuna oranı.
qkv_bias (`bool`, *isteğe bağlı*, varsayılan `True`) : Sorgulara, anahtarlara ve değerlere bir sapma (bias) eklenip eklenmeyeceğini belirtir.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
drop_path_rate (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Yama birleştirme için drop path oranı.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
use_absolute_embeddings (`bool`, *isteğe bağlı*, varsayılan `False`) : Mutlak konum gömme kullanılıp kullanılmayacağı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
upscale (`int`, *opsiyonel*, varsayılan 2) : Görsel için büyütme çarpanı. Görsel süper çözünürlük için 2/3/4/8, gürültü azaltma ve sıkıştırma artefaktı azaltma için 1
img_range (`float`, *isteğe bağlı*, varsayılan 1.0) : Girdi görüntüsünün değer aralığı.
resi_connection (`str`, *isteğe bağlı*, varsayılan `"1conv"`) : Her aşamada, artımsal bağlantıdan önce kullanılacak konvolüsyon bloğu.
upsampler (`str`, *isteğe bağlı*, varsayılan `"pixelshuffle"`) : Yeniden yapılandırma modülü. 'pixelshuffle'/'pixelshuffledirect'/'nearest+conv'/None olabilir.
Bu, bir Swin2SRModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Swin2Sr modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturulduğunda, [caidas/swin2sr-classicalsr-x2-64](https://huggingface.co/caidas/swin2sr-classicalsr-x2-64) modelinin yapılandırmasına benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import Swin2SRConfig, Swin2SRModel
>>> # Initializing a Swin2SR caidas/swin2sr-classicalsr-x2-64 style configuration
>>> configuration = Swin2SRConfig()
>>> # Initializing a model (with random weights) from the caidas/swin2sr-classicalsr-x2-64 style configuration
>>> model = Swin2SRModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Swin2SRModel[[transformers.Swin2SRModel]]
#### transformers.Swin2SRModel[[transformers.Swin2SRModel]]
```python
transformers.Swin2SRModel(config: Swin2SRConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L710)
**Parametreler:**
config ([Swin2SRConfig](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde herhangi bir özel head olmadan ham hidden-states üreten çıplak Swin2Sr Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.Swin2SRModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L752)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [Swin2SRImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [Swin2SRImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [Swin2SRImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRImageProcessor) kullanır).
output_attentions (`bool`, *isteğe bağlı*) : Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmediğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `attentions` bölümüne bakın.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
**Dönüş:** [BaseModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) veya `tuple(torch.Tensor)`
[BaseModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([Swin2SRConfig](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[Swin2SRModel](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
```
## Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
#### transformers.Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
```python
transformers.Swin2SRForImageSuperResolution(config: Swin2SRConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L943)
**Parametreler:**
config ([Swin2SRConfig](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Görüntü süper çözünürlüğü ve onarımı için üstünde bir yükseltici başlık bulunan Swin2SR model dönüştürücüsü.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.Swin2SRForImageSuperResolution.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L970)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [Swin2SRImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [Swin2SRImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [Swin2SRImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRImageProcessor) kullanır).
labels (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Maskeli dil modelleme kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.vocab_size]` aralığında olmalı ya da -100 olmalı (`input_ids` docstring'ine bakın). Endeksleri `-100` olarak ayarlanan tokenlar yok sayılır (maskelenir), kayıp yalnızca `[0, ..., config.vocab_size]` aralığında etiketlere sahip tokenlar için hesaplanır.
output_attentions (`bool`, *isteğe bağlı*) : Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmediğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `attentions` bölümüne bakın.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
**Dönüş:** `ImageSuperResolutionOutput` veya `tuple(torch.Tensor)`
A `ImageSuperResolutionOutput` veya bir `torch.Tensor` tuple'ı (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([Swin2SRConfig](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[Swin2SRForImageSuperResolution](/docs/transformers/v5.23.0/tr/model_doc/swin2sr#transformers.Swin2SRForImageSuperResolution) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Yeniden yapılandırma kaybı.
- **yeniden inşası** (`torch.Tensor`, şekli `(batch_size, num_channels, height, width)`) -- Yeniden inşa edilen görüntüler, gerekirse ölçeklendirilmiş.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her aşamanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`. Modelin her aşamanın çıktısındaki gizli durumları (aynı zamanda özellik haritaları olarak da adlandırılır).
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, patch_size, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>> from io import BytesIO
>>> from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution
>>> processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> url = "https://huggingface.co/spaces/jjourney1125/swin2sr/resolve/main/samples/butterfly.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # prepare image for the model
>>> inputs = processor(image, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> output = outputs.reconstruction.data.squeeze().float().cpu().clamp_(0, 1).numpy()
>>> output = np.moveaxis(output, source=0, destination=-1)
>>> output = (output * 255.0).round().astype(np.uint8) # float32 to uint8
>>> # you can visualize `output` with `Image.fromarray`
```