
Diffusers documentation
Marigold Vision par ordinateur
Marigold Vision par ordinateur
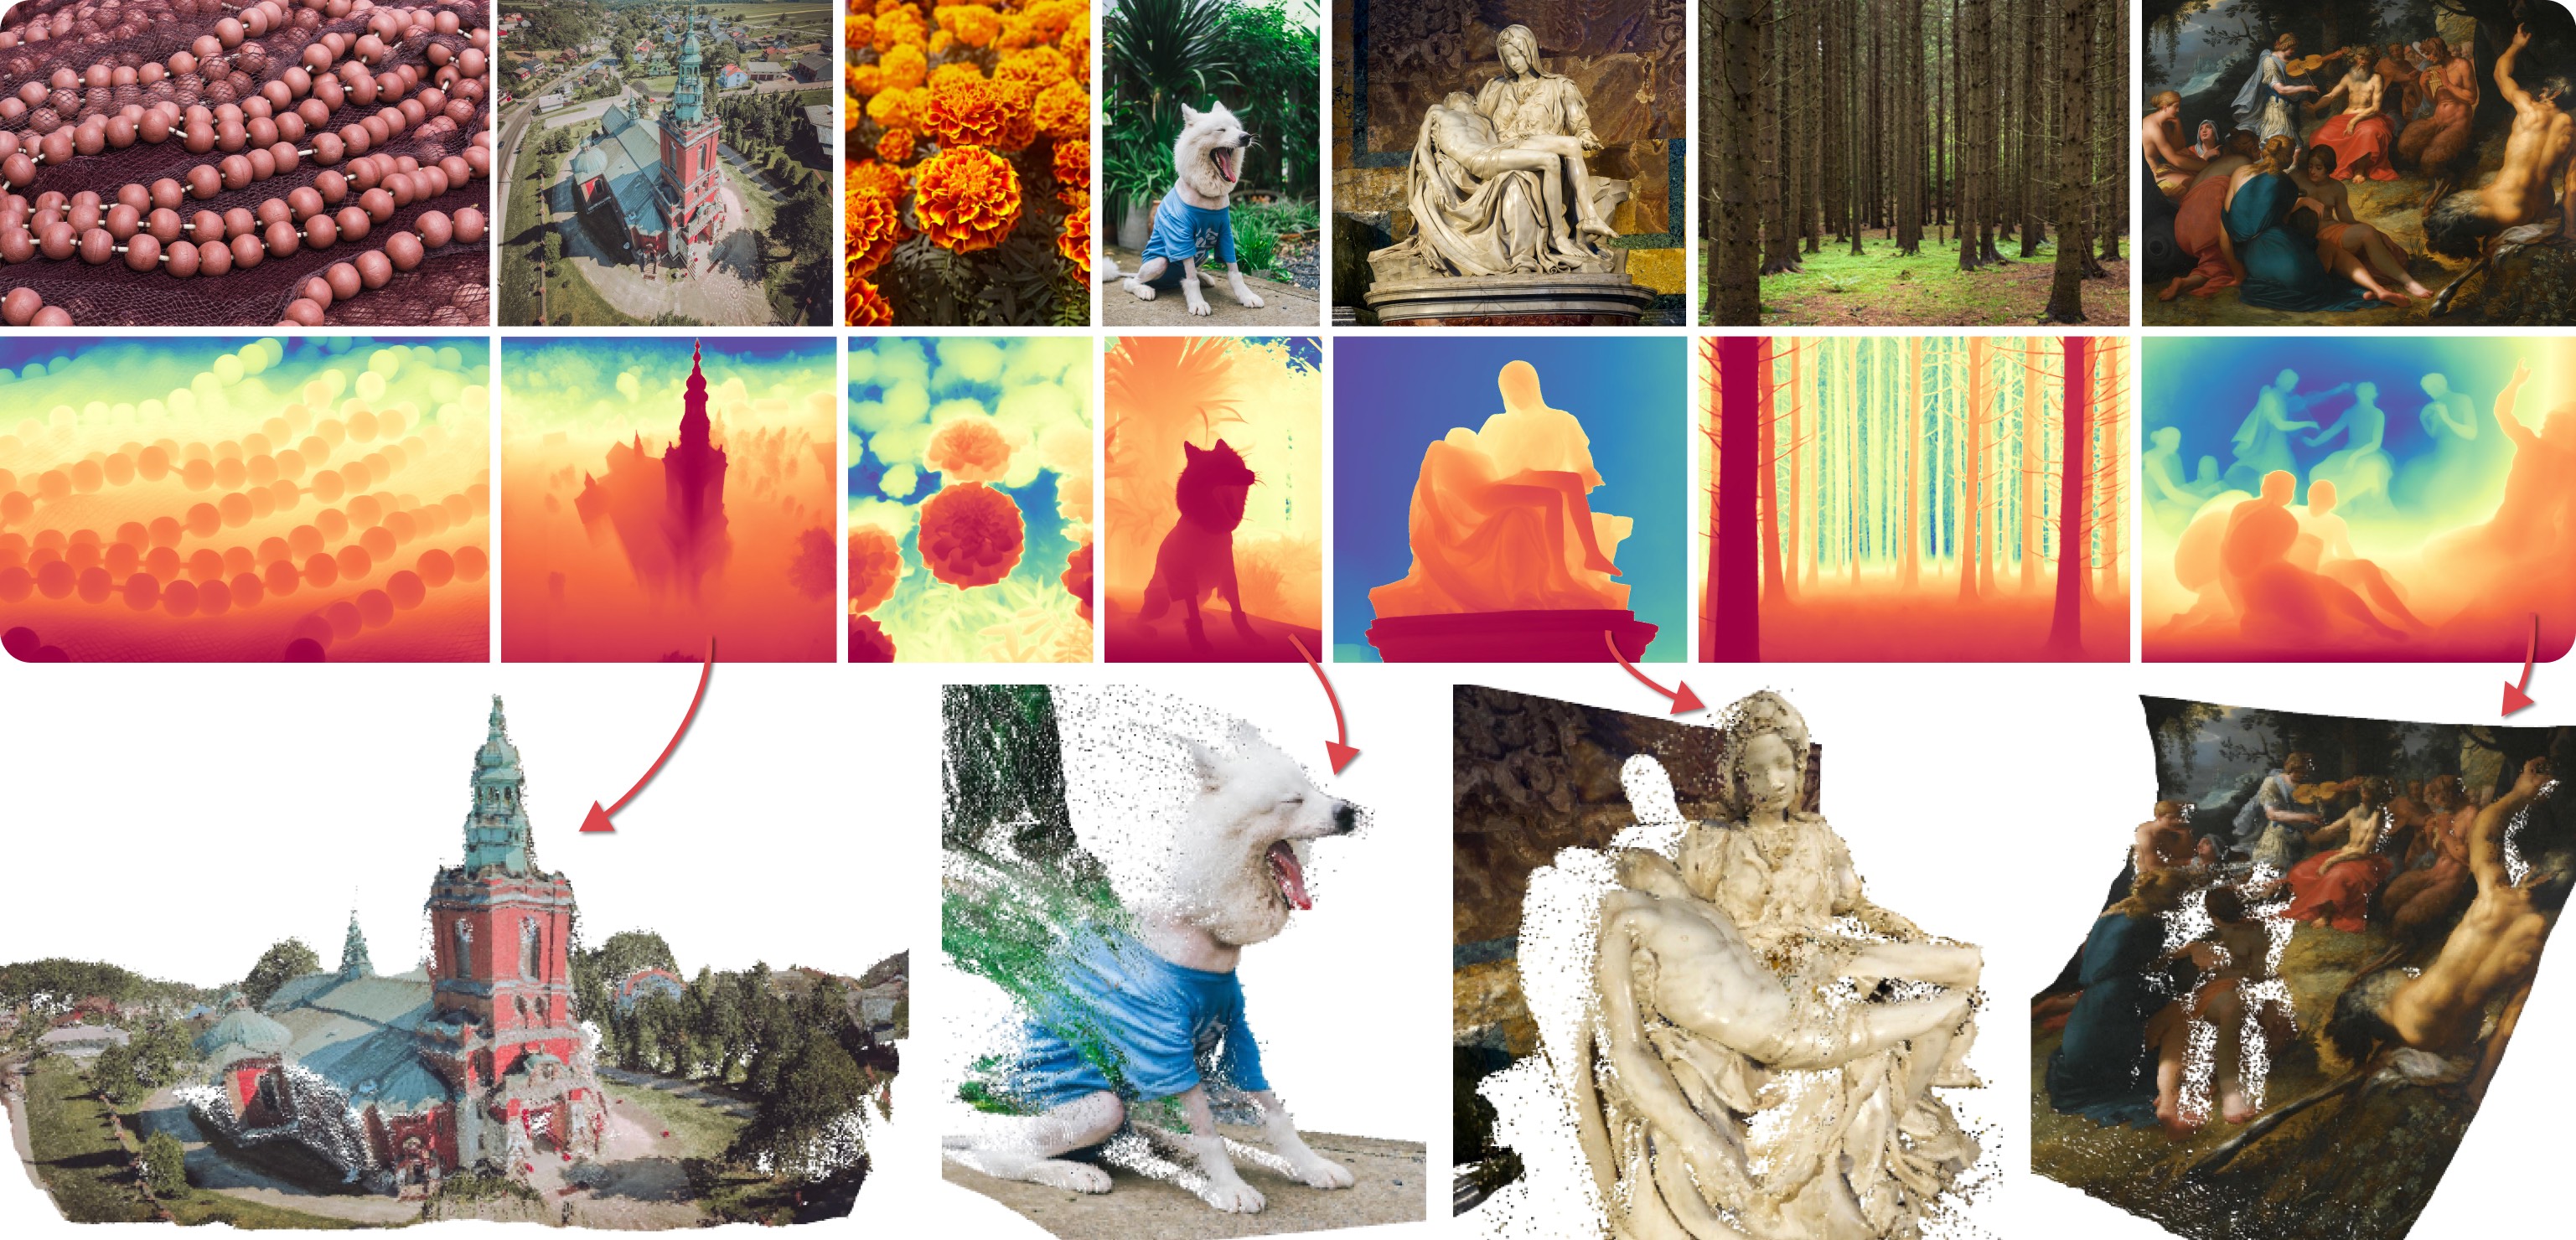
Marigold a été proposé dans Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation, un article oral de CVPR 2024 de Bingxin Ke, Anton Obukhov, Shengyu Huang, Nando Metzger, Rodrigo Caye Daudt et Konrad Schindler. L’idée centrale est de réutiliser le prior génératif des modèles de diffusion latente Text-to-Image (LDM) pour des tâches traditionnelles de vision par ordinateur. Cette approche a été explorée en effectuant un fine-tuning de Stable Diffusion pour l'estimation de profondeur monoculaire, comme le montre l’image d’illustration ci-dessus.
Marigold a ensuite été étendu dans l'article de suivi, Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis, co-signé par Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov et Konrad Schindler. Ce travail a élargi Marigold pour prendre en charge de nouvelles modalités telles que les Surface Normals et la Intrinsic Image Decomposition (IID), a introduit un protocole d'entraînement pour les Latent Consistency Models (LCM) et a démontré la capacité de traitement en High-Resolution (HR).
Les premiers modèles Marigold (
v1-0et antérieurs) étaient optimisés pour obtenir les meilleurs résultats avec au moins 10 étapes d’inférence. Les modèles LCM ont été développés par la suite pour permettre une inférence de haute qualité en seulement 1 à 4 étapes. Les modèles Marigoldv1-1et ultérieurs utilisent le planificateur DDIM pour obtenir des résultats optimaux en aussi peu que 1 à 4 étapes.
Pipelines disponibles
Chaque pipeline est conçu pour une tâche de vision par ordinateur spécifique, traitant une image RGB en entrée et générant une prédiction correspondante. Actuellement, les tâches de vision par ordinateur suivantes sont implémentées :
| Pipeline | Points de contrôle de modèles recommandés | Spaces (Applications interactives) | Modalités prédites |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | Estimation de la profondeur | Profondeur, Disparité |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | Estimation des normales de surface | Normales de surface |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1, prs-eth/marigold-iid-lighting-v1-1 | Décomposition d'image intrinsèque | Albédo, Matériaux, Éclairage |
Points de contrôle disponibles
Tous les points de contrôle originaux sont disponibles sous l’organisation PRS-ETH sur Hugging Face. Ils sont conçus pour être utilisés avec les pipelines diffusers et le code source original, qui peut également servir à entraîner de nouveaux points de contrôle de modèles. Voici un résumé des points de contrôle recommandés, qui produisent tous des résultats fiables en 1 à 4 étapes.
| Point de contrôle | Modalité | Comment |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | Profondeur | La prédiction de profondeur invariante par affinité attribue à chaque pixel une valeur comprise entre 0 (plan proche) et 1 (plan lointain), les deux plans étant déterminés par le modèle lors de l'inférence. |
| prs-eth/marigold-normals-v0-1 | Normales | Les prédictions des normales de surface sont des vecteurs 3D de longueur unitaire dans l'espace écran de la caméra, avec des valeurs comprises entre -1 et 1. |
| prs-eth/marigold-iid-appearance-v1-1 | Intrinsèques | La décomposition d'InteriorVerse est composée de l'Albedo et de deux propriétés de matériau BRDF : Roughness et Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | Intrinsèques | Décomposition HyperSim d'une image est composée de l'Albédo $A$, de l'ombrage diffus $S$ et du résidu non diffus $R$ : $I = A*S+R$. |
Pensez à consulter le guide sur les Schedulers pour apprendre à explorer le compromis entre la vitesse et la qualité du scheduler, et à consulter la section réutilisation des composants entre les pipelines pour apprendre à charger efficacement les mêmes composants dans plusieurs pipelines. En outre, pour en savoir plus sur la réduction de l'utilisation de la mémoire de ce pipeline, reportez-vous à la section [“Reduce memory usage”] ici.
Les pipelines Marigold ont été conçus et testés avec le planificateur intégré au point de contrôle du modèle. Le nombre optimal d'étapes d'inférence varie selon le planificateur, sans valeur universelle qui soit la meilleure dans tous les cas. Pour s'adapter à cela, le paramètre
num_inference_stepsde la méthode__call__du pipeline a par défaut la valeurNone(voir la référence de l'API). Sauf s'il est défini explicitement, il hérite de la valeur du champdefault_denoising_stepsdu fichier de configuration du point de contrôle (model_index.json). Cela garantit des prédictions de haute qualité lors de l'appel du pipeline avec uniquement l'argumentimage.
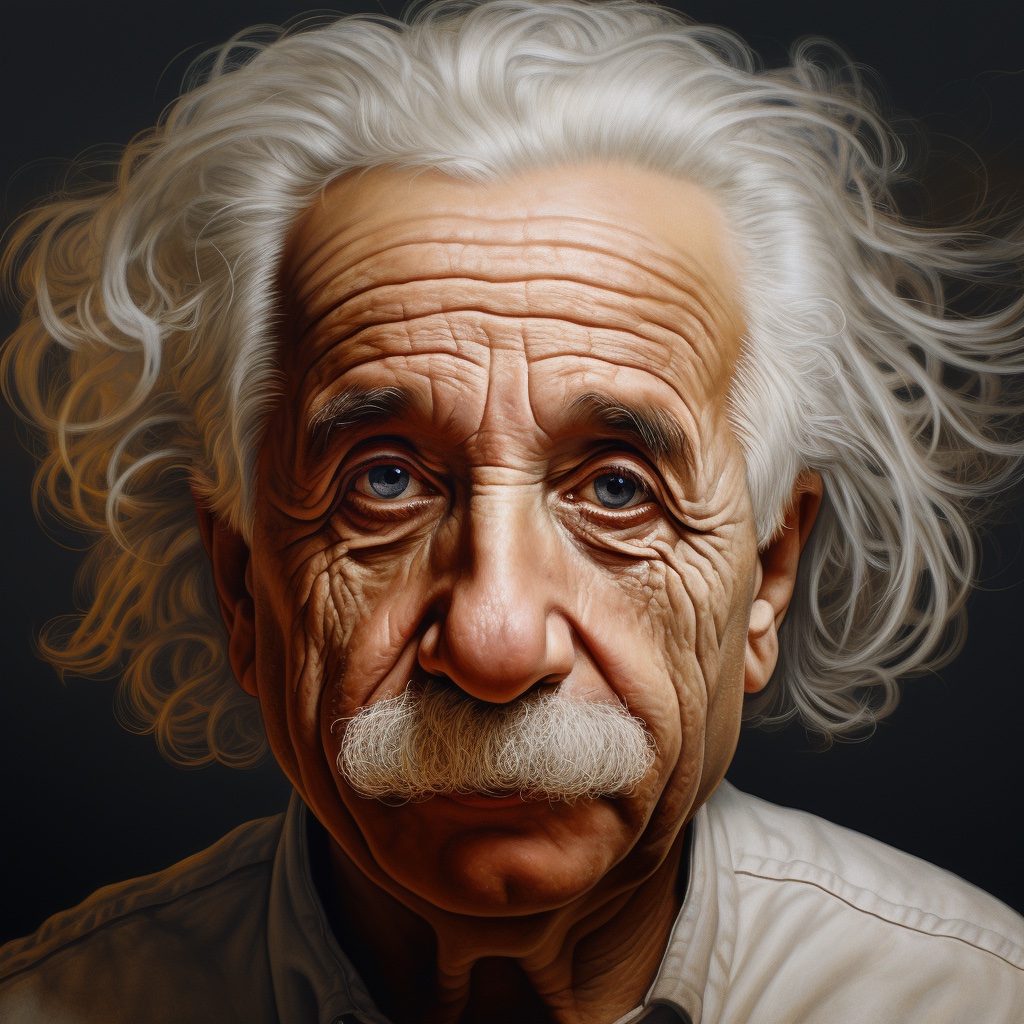
Les exemples ci-dessous sont principalement donnés pour la prédiction de profondeur, mais ils peuvent être appliqués de manière universelle à d'autres modalités prises en charge. Nous présentons les prédictions en utilisant la même image d'Albert Einstein générée par Midjourney. Cela facilite la comparaison des visualisations des prédictions entre les différentes modalités et points de contrôle.
Prédiction de la profondeur
Pour obtenir une prédiction de profondeur, chargez le point de contrôle prs-eth/marigold-depth-v1-1 dans MarigoldDepthPipeline,
faites passer l’image dans le pipeline, puis enregistrez les prédictions :
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
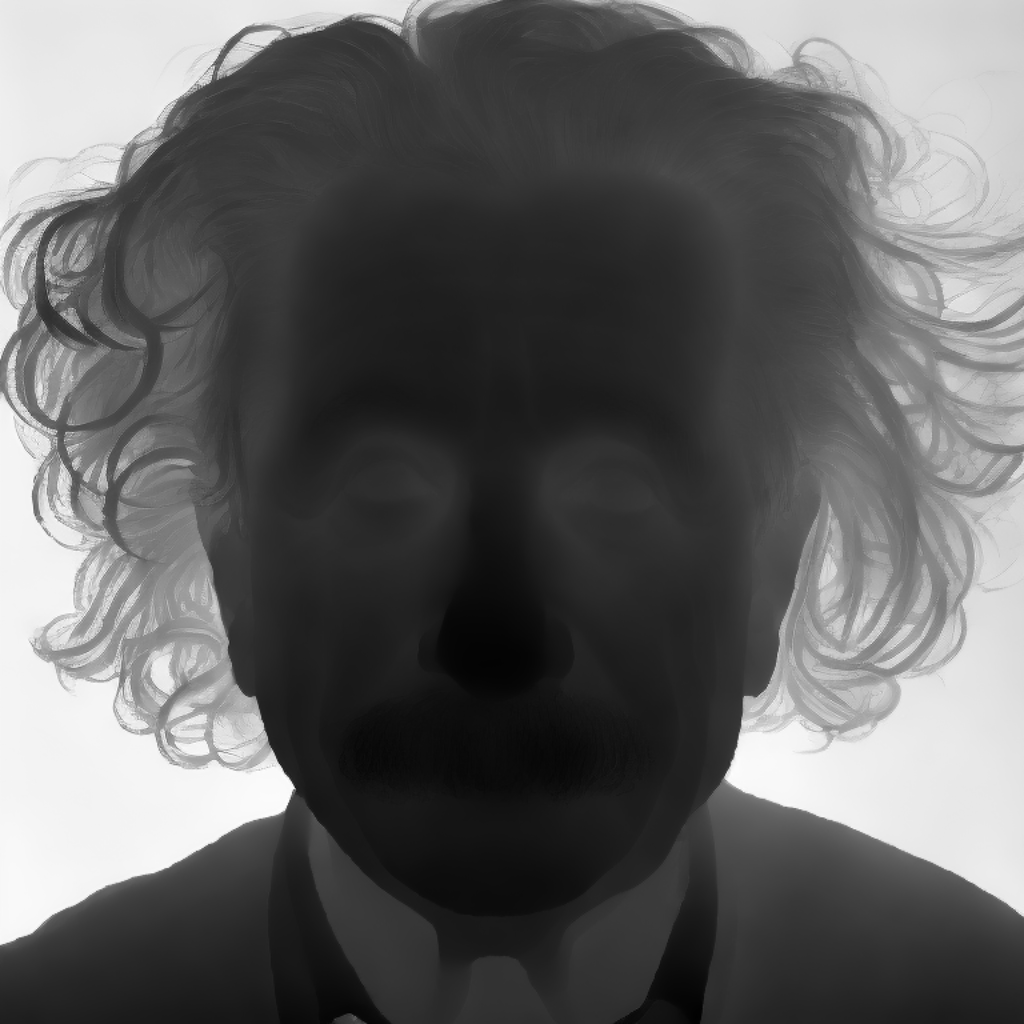
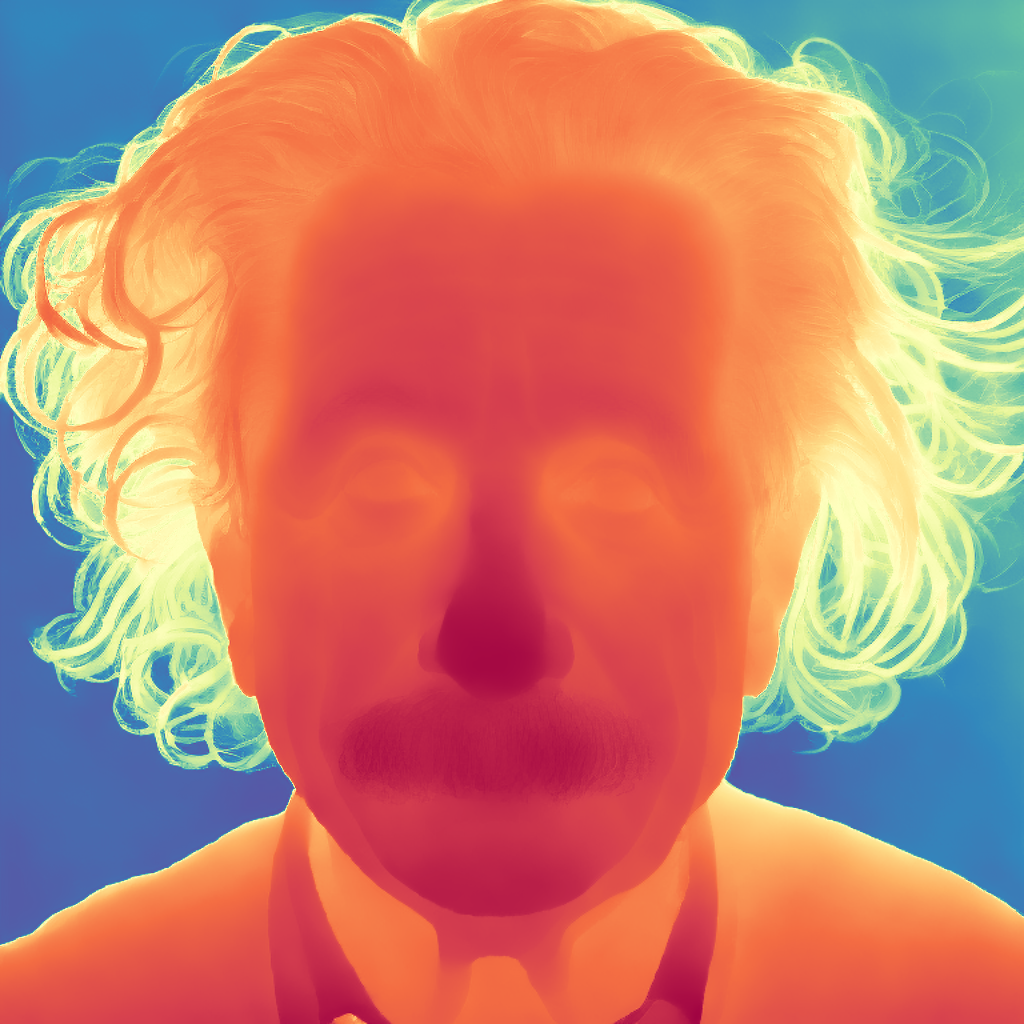
La fonction visualize_depth() applique l’une des cartes de couleurs de matplotlib (Spectral par défaut) pour mapper les valeurs de pixels prédites, issues d’une plage de profondeur monocanal [0, 1], vers une image RGB.
Avec la carte de couleurs Spectral, les pixels proches sont peints en rouge et les pixels éloignés en bleu.
Le fichier PNG 16 bits stocke les valeurs du canal unique, mappées linéairement de la plage [0, 1] vers [0, 65535].
Ci-dessous figurent les prédictions brutes et visualisées. Les zones plus sombres et plus proches (la moustache) sont plus faciles à distinguer dans
la visualisation.
Estimation des normales de surface
Chargez le point de contrôle prs-eth/marigold-normals-v1-1 dans MarigoldNormalsPipeline, passez l’image dans le pipeline et enregistrez les prédictions :
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
La fonction visualize_normals() convertit la prédiction tridimensionnelle, dont les valeurs de pixels sont comprises dans l'intervalle [-1, 1], en une image RGB.
La fonction de visualisation permet d'inverser les axes des normales de surface afin de rendre la visualisation compatible avec d'autres choix de repère.
Conceptuellement, chaque pixel est coloré en fonction du vecteur normale de surface dans le repère, où l'axe X pointe vers la droite, l'axe Y pointe vers le haut et l'axe Z pointe vers l'observateur.
Voici la prédiction visualisée :

Dans cet exemple, la pointe du nez a presque certainement un point sur la surface, dont le vecteur normal pointe
directement vers l’observateur, ce qui signifie que ses coordonnées sont [0, 0, 1].
Ce vecteur correspond à la valeur RGB [128, 128, 255], qui correspond à la couleur bleu-violet.
De même, une normale de surface sur la joue dans la partie droite de l’image a une grande composante X, ce qui augmente
la teinte rouge.
Les points sur les épaules pointant vers le haut avec une grande Y favorisent la couleur verte.
Décomposition d'image intrinsèque
Marigold fournit deux modèles pour la décomposition d'image intrinsèque (IID) : « Appearance » et « Lighting ». Chaque modèle produit des cartes d'albédo, dérivées respectivement des annotations d'InteriorVerse et de Hypersim.
- Le modèle « Appearance » estime également les propriétés de matériau : Roughness et Metallicity.
- Le modèle « Lighting » génère l'ombrage diffus et le résidu non diffus.
Voici le code d’exemple qui enregistre les prédictions effectuées par le modèle « Appearance » :
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
Un autre exemple illustrant les prédictions effectuées par le modèle « Lighting » :
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
Les deux modèles partagent le même pipeline tout en prenant en charge différents types de décomposition.
La paramétrisation exacte de la décomposition (par exemple, espace sRGB vs. espace linéaire) est stockée dans le dictionnaire pipe.target_properties, qui est transmis à la fonction visualize_intrinsics().
Voici quelques exemples illustrant les sorties de décomposition prédites. Toutes les modalités peuvent être examinées dans l’espace Intrinsic Image Decomposition.


Accélérer l'inférence
Les extraits de démarrage rapide ci-dessus sont déjà optimisés pour la qualité et la vitesse : ils chargent le point de contrôle, utilisent la variante fp16 des poids et des calculs, et effectuent le nombre par défaut (4) d'étapes de débruitage par diffusion.
La première étape pour accélérer l'inférence, au détriment de la qualité de la prédiction, consiste à réduire les étapes de débruitage par diffusion au minimum :
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
Avec ce changement, l’appel pipe s’achève en 280 ms sur un GPU RTX 3090.
En interne, l’image d’entrée est d’abord encodée à l’aide de l’encodeur VAE de Stable Diffusion, puis une seule étape de débruitage est effectuée par le U-Net.
Enfin, le latent de prédiction est décodé par le décodeur VAE dans l’espace des pixels.
Dans cette configuration, deux des trois appels de modules sont consacrés à la conversion entre les espaces pixel et latent du LDM.
Puisque l’espace latent de Marigold est compatible avec Stable Diffusion 2.0, l’inférence peut être accélérée de plus de 3x,
réduisant le temps d’appel à 85 ms sur un RTX 3090, en utilisant un remplacement léger du VAE SD.
Notez que l’utilisation d’un VAE léger peut légèrement réduire la qualité visuelle des prédictions.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Jusqu'à présent, nous avons optimisé le nombre d'étapes de diffusion et les composants du modèle. Les opérations d'auto-attention représentent une part importante des calculs. Les accélérer peut se faire en utilisant un processeur d'attention plus efficace :
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Enfin, comme suggéré dans Optimizations, l’activation de torch.compile peut améliorer encore les performances, selon le matériel cible.
Cependant, la compilation entraîne un surcoût important lors de la première invocation du pipeline, ce qui n’est avantageux que lorsque la même instance de pipeline est appelée de manière répétée, par exemple dans une boucle.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Maximiser la précision et le regroupement
Les pipelines Marigold disposent d'un mécanisme d'ensembling intégré qui combine plusieurs prédictions issues de différents latents aléatoires.
Il s'agit d'une méthode par la force brute pour améliorer la précision des prédictions, en tirant parti de la nature générative de la diffusion.
Le chemin d'ensembling est activé automatiquement lorsque l'argument ensemble_size est défini à une valeur supérieure ou égale à 3.
Lorsque l'on vise une précision maximale, il est judicieux d'ajuster num_inference_steps simultanément à ensemble_size.
Les valeurs recommandées varient selon les points de contrôle, mais dépendent principalement du type de planificateur.
L'effet de l'ensembling est particulièrement bien visible avec les normales de surface :
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 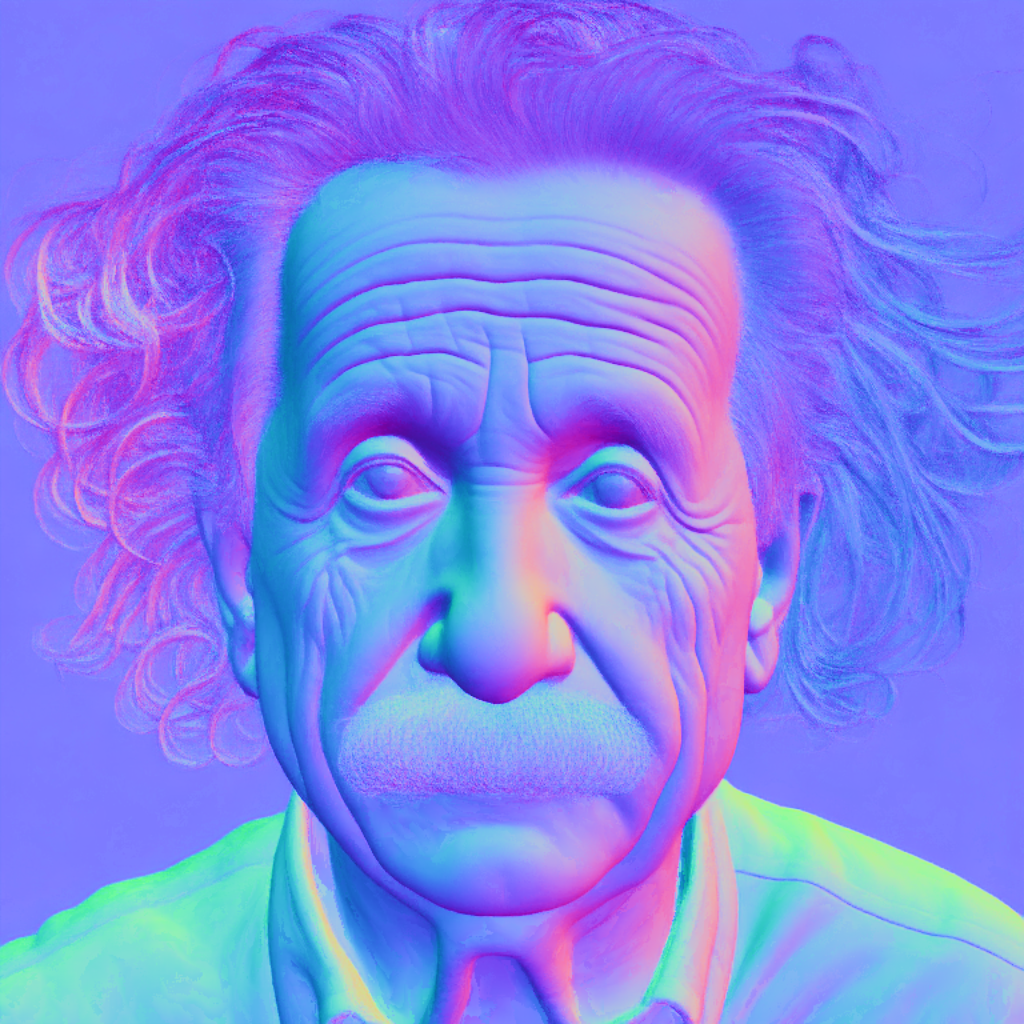
Comme on peut le constater, toutes les zones présentant des structures fines, comme les cheveux, ont obtenu des prédictions plus conservatrices et, en moyenne, plus correctes. Un tel résultat est plus adapté aux tâches en aval sensibles à la précision, telles que la reconstruction 3D.
Traitement vidéo image par image avec cohérence temporelle
En raison de la nature générative de Marigold, chaque prédiction est unique et définie par le bruit aléatoire échantillonné pour l’initialisation latente. Cela constitue un inconvénient évident par rapport aux réseaux de régression dense de bout en bout traditionnels, comme l’illustrent les vidéos suivantes :
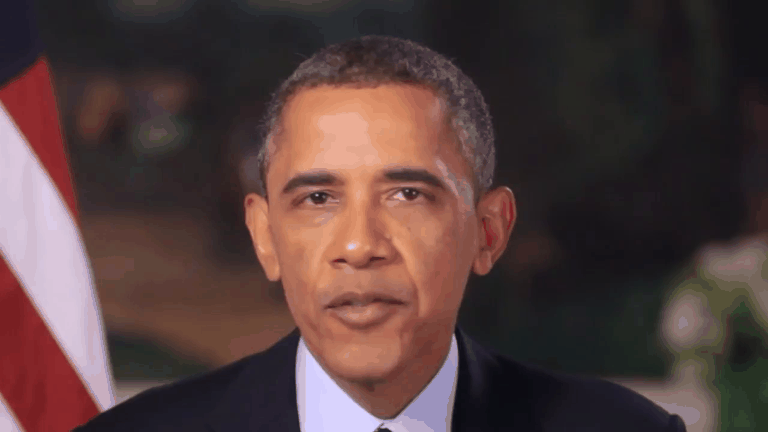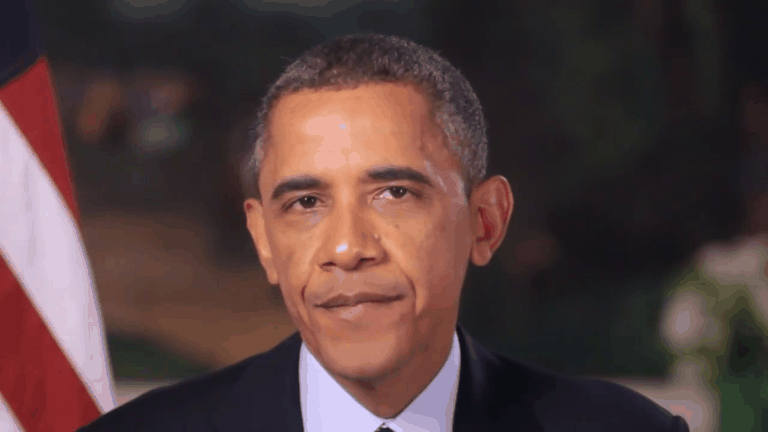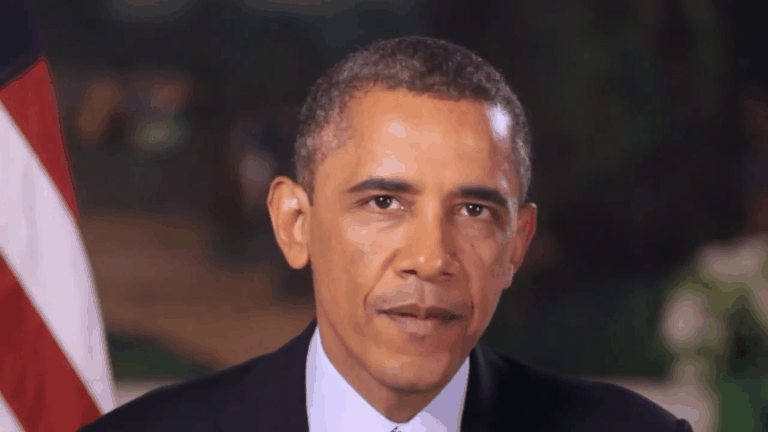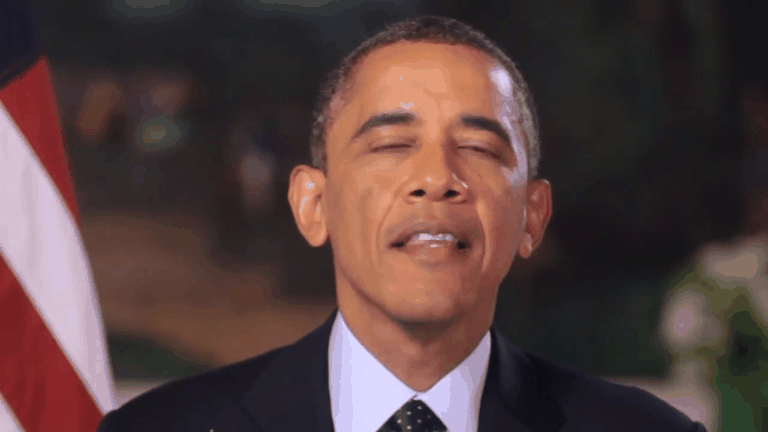
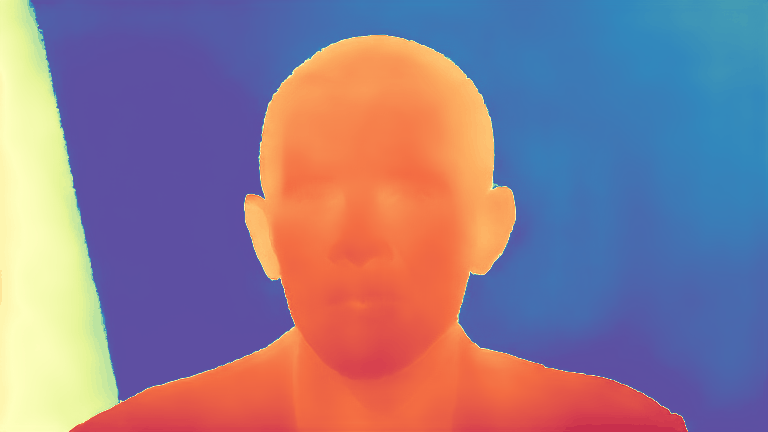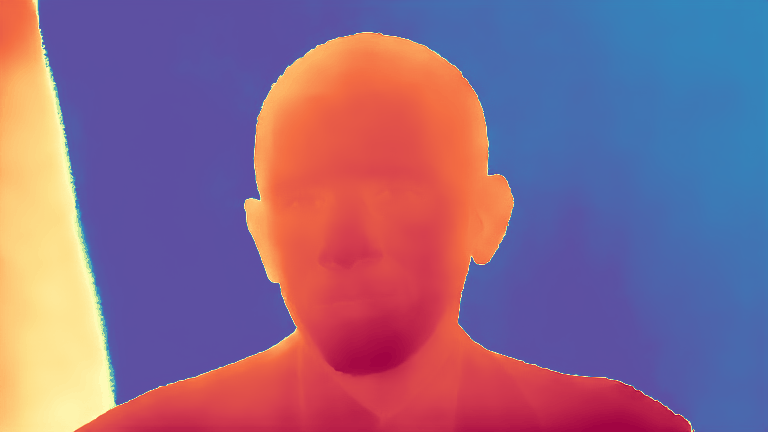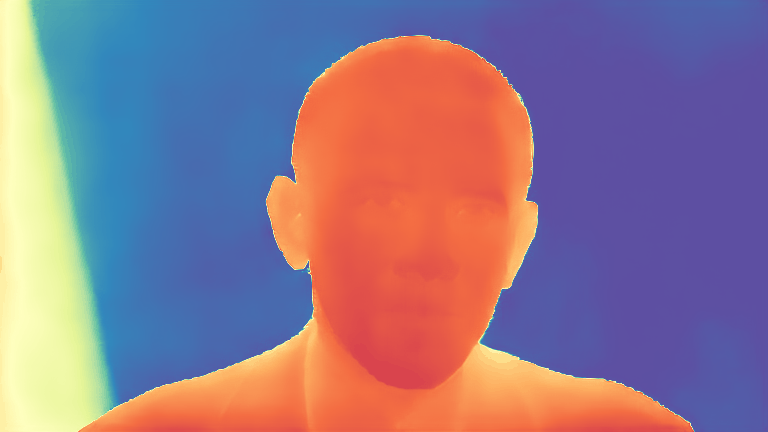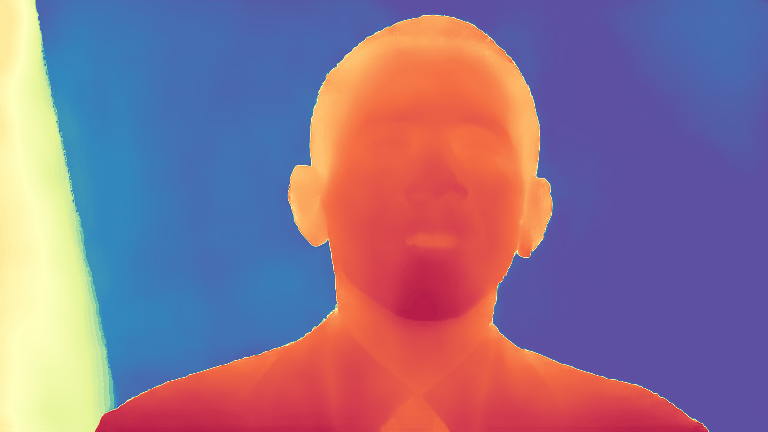
Pour résoudre ce problème, il est possible de passer l'argument latents aux pipelines, ce qui définit le point de départ de la diffusion.
Empiriquement, nous avons constaté qu'une combinaison convexe du bruit latent correspondant au point de départ et du latent correspondant à la prédiction de la frame précédente donne des résultats suffisamment lisses, comme implémenté dans l'extrait de code ci-dessous :
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
Ici, le processus de diffusion démarre à partir du latent calculé fourni.
Le pipeline définit output_latent=True pour accéder à out.latent et calcule sa contribution à l’initialisation du latent de la frame suivante.
Le résultat est désormais beaucoup plus stable :

Marigold pour ControlNet
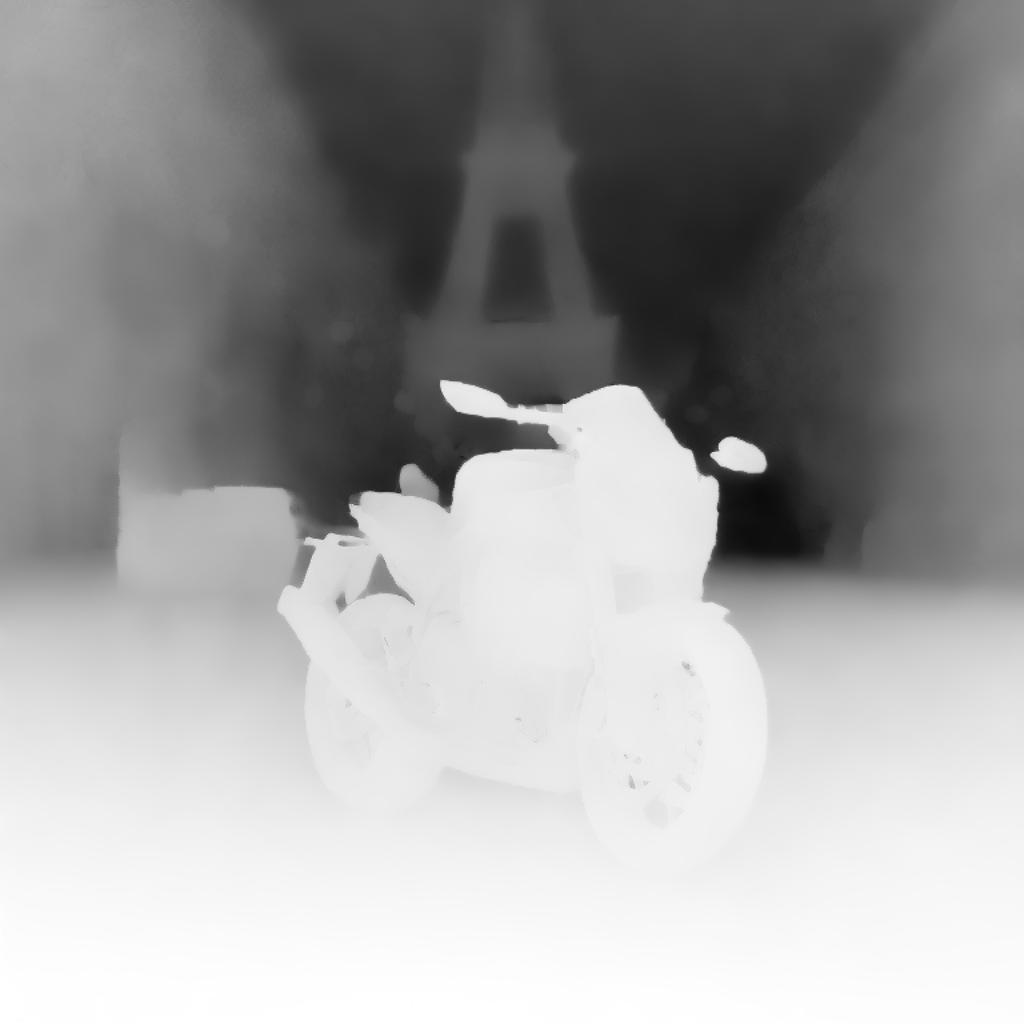
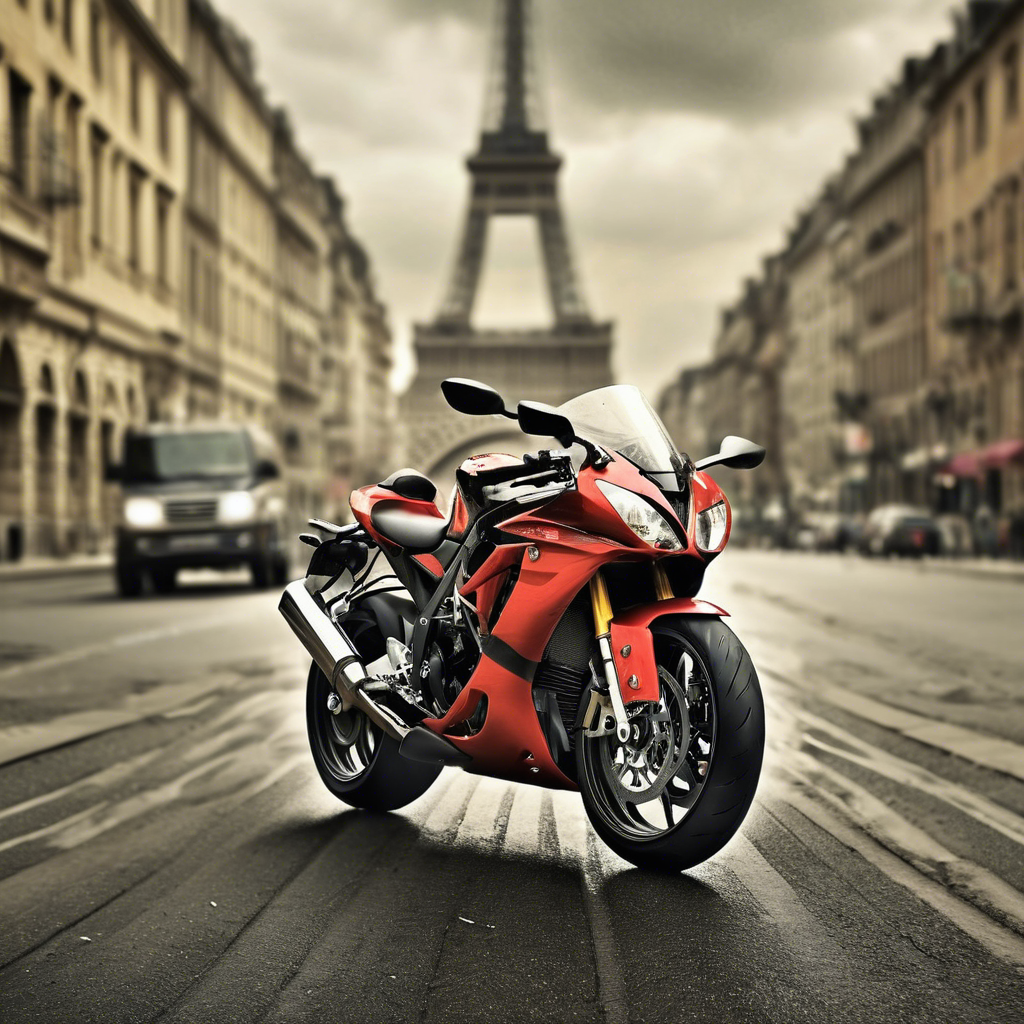
Une application très courante de la prédiction de profondeur avec des modèles de diffusion est son utilisation conjointe avec ControlNet. La netteté de la profondeur joue un rôle crucial pour obtenir des résultats de haute qualité avec ControlNet. Comme le montrent les comparaisons avec d'autres méthodes ci-dessus, Marigold excelle dans cette tâche. L'extrait de code ci-dessous montre comment charger une image, calculer la profondeur et la transmettre à ControlNet dans un format compatible :
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")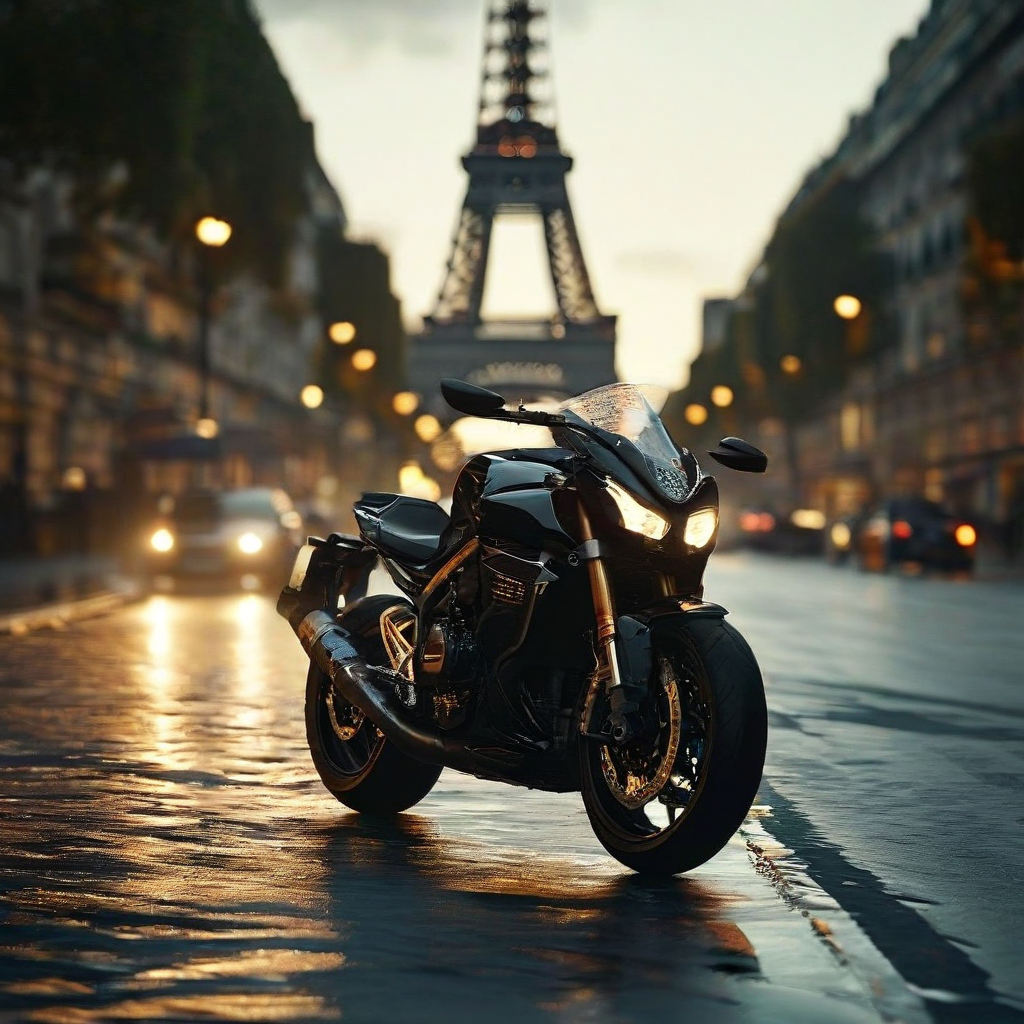
Évaluation quantitative
Pour évaluer Marigold de manière quantitative sur des classements et des jeux de données de référence standard (tels que NYU, KITTI et d'autres),
suivez le protocole d'évaluation décrit dans l'article : chargez le modèle en précision complète fp32 et utilisez des valeurs appropriées
pour num_inference_steps et ensemble_size.
Faites éventuellement un tirage aléatoire (seed) pour garantir la reproductibilité.
Maximiser batch_size permettra d'obtenir une utilisation maximale de l'appareil.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
Utilisation de l'incertitude prédictive
Le mécanisme d'ensembling intégré aux pipelines Marigold combine plusieurs prédictions obtenues à partir de différents latents aléatoires.
En conséquence, il peut être utilisé pour quantifier l'incertitude épistémique (du modèle) ; il suffit de spécifier ensemble_size supérieur ou égal à 3 et de définir output_uncertainty=True.
L'incertitude résultante sera disponible dans le champ uncertainty de la sortie.
Elle peut être visualisée comme suit :
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")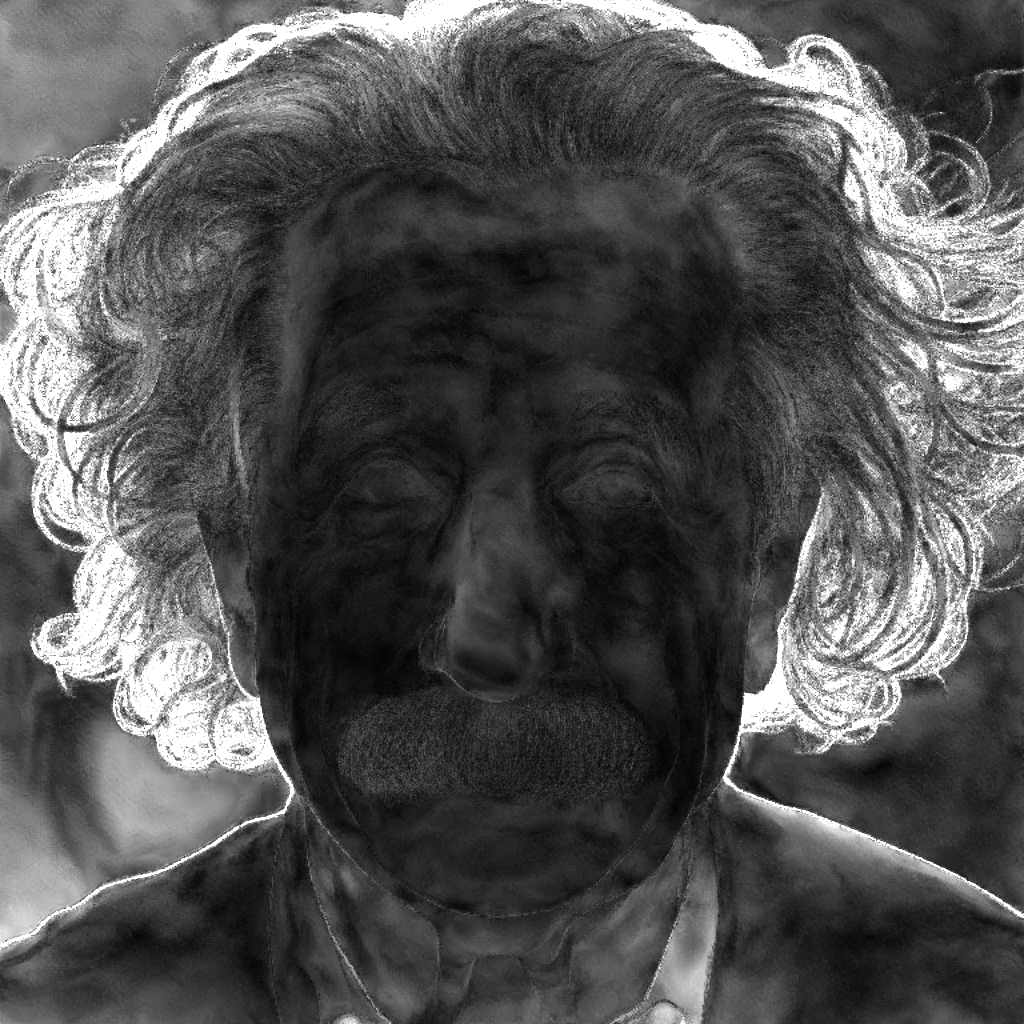
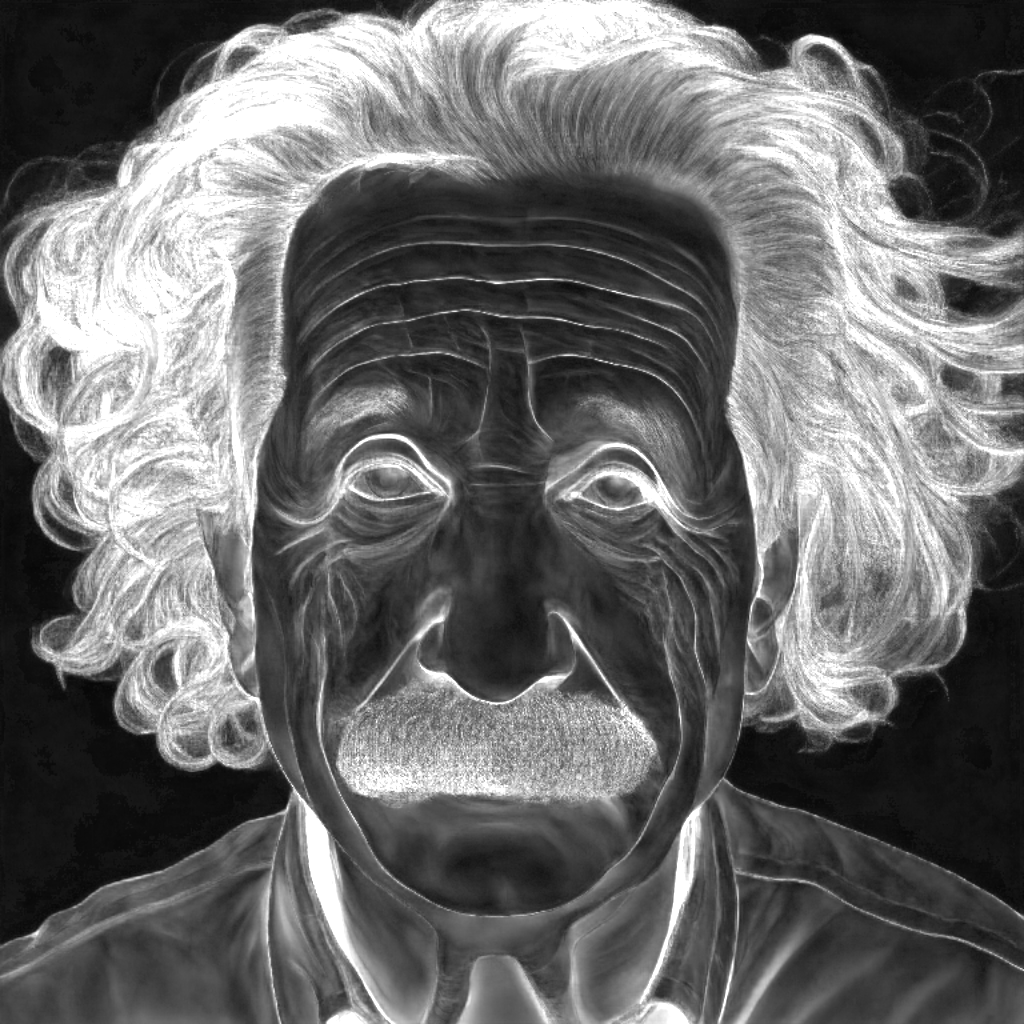

L'interprétation de l'incertitude est simple : les valeurs élevées (blanc) correspondent aux pixels pour lesquels le modèle a du mal à produire des prédictions cohérentes.
- Le modèle de profondeur présente l'incertitude la plus élevée autour des discontinuités, là où la profondeur des objets change brusquement.
- Le modèle de normales de surface est le moins fiable pour les structures fines comme les cheveux et pour les zones sombres telles que le col.
- L'incertitude de l'albédo est représentée sous forme d'image RVB, car elle capture l'incertitude de manière indépendante pour chaque canal de couleur, contrairement à la profondeur et aux normales de surface. Elle est également plus élevée dans les zones ombragées et aux discontinuités.
API de prédiction de profondeur Marigold
classe diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Paramètres
- unet (
UNet2DConditionModel) — U-Net conditionnel pour débruyer le latent de profondeur, conditionné sur le latent d'image. - vae (
AutoencoderKL) — Modèle de Variational Auto-Encoder (VAE) pour encoder et décoder des images et des prédictions vers et depuis des représentations latentes. - scheduler (
DDIMSchedulerouLCMScheduler) — Un planificateur à utiliser en combinaison avecunetpour débruyer les latents de l'image encodée. - text_encoder (
CLIPTextModel) — Encodeur de texte, pour l’incorporation de texte vide. - tokenizer (
CLIPTokenizer) — Tokeniseur CLIP. - prediction_type (
str, facultatif) — Type de prédictions effectuées par le modèle. - scale_invariant (
bool, facultatif) — Propriété du modèle indiquant si les cartes de profondeur prédites sont invariantes à l'échelle. Cette valeur doit être définie dans la configuration du modèle. Utilisée conjointement avec le drapeaushift_invariant=True, le modèle est également appelé « affine-invariant ». NB : la surcharge de cette valeur n'est pas prise en charge. - shift_invariant (
bool, facultatif) — Propriété du modèle indiquant si les cartes de profondeur prédites sont invariantes par translation. Cette valeur doit être définie dans la configuration du modèle. Utilisée conjointement avec le drapeauscale_invariant=True, le modèle est également appelé « affine-invariant ». NB : la surcharge de cette valeur n’est pas prise en charge. - default_denoising_steps (
int, facultatif) — Le nombre minimal d’étapes de débruitage de diffusion nécessaires pour produire une prédiction de qualité raisonnable avec le modèle donné. Cette valeur doit être définie dans la configuration du modèle. Lorsque le pipeline est appelé sans définir explicitementnum_inference_steps, la valeur par défaut est utilisée. Cela est requis pour garantir des résultats raisonnables avec les différentes variantes de modèles compatibles avec le pipeline, telles que celles qui reposent sur des calendriers de débruitage très courts (LCMScheduler) et celles avec des calendriers de diffusion complets (DDIMScheduler). - default_processing_resolution (
int, facultatif) — La valeur recommandée du paramètreprocessing_resolutiondu pipeline. Cette valeur doit être définie dans la configuration du modèle. Lorsque le pipeline est appelé sans définir explicitementprocessing_resolution, la valeur par défaut est utilisée. Cela est nécessaire pour garantir des résultats raisonnables avec les différentes variantes de modèles entraînées avec des valeurs de résolution de traitement optimales variables.
Pipeline pour l'estimation de profondeur monoculaire utilisant la méthode Marigold : https://marigoldmonodepth.github.io.
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
Paramètres
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: une image d’entrée ou des images utilisées comme entrée pour la tâche d’estimation de profondeur. Pour les tableaux et les tenseurs, la plage de valeurs attendue est comprise entre[0, 1]. Il est possible de passer un lot d’images en fournissant un tableau ou un tenseur à quatre dimensions. De plus, une liste d’images sous forme de tableaux ou de tenseurs à deux ou trois dimensions peut être transmise. Dans ce dernier cas, tous les éléments de la liste doivent avoir la même largeur et la même hauteur. - num_inference_steps (
int, facultatif, valeur par défautNone) — Nombre d'étapes de diffusion de débruitage lors de l'inférence. La valeur par défautNoneentraîne une sélection automatique. - ensemble_size (
int, par défaut1) — Nombre de prédictions d'ensemble. Des valeurs plus élevées entraînent des améliorations mesurables et une dégradation visuelle. - processing_resolution (
int, facultatif, valeur par défautNone) — Résolution de traitement effective. Si définie sur0, elle correspond à la dimension la plus grande de l'image d'entrée. Cela produit des prédictions plus nettes, mais peut également entraîner une perte du contexte global. La valeur par défautNonese résout à la valeur optimale issue de la configuration du modèle. - match_input_resolution (
bool, facultatif, valeur par défautTrue) — Lorsqu’activé, la prédiction de sortie est redimensionnée pour correspondre aux dimensions de l’entrée. Lorsqu’il est désactivé, le côté le plus long de la sortie sera égal àprocessing_resolution. - resample_method_input (
str, facultatif, par défaut"bilinear") — Méthode de rééchantillonnage utilisée pour redimensionner les images d'entrée versprocessing_resolution. Les valeurs acceptées sont :"nearest","nearest-exact","bilinear","bicubic"ou"area". - resample_method_output (
str, facultatif, par défaut"bilinear") — Méthode de rééchantillonnage utilisée pour redimensionner les prédictions de sortie afin de correspondre à la résolution d'entrée. Les valeurs acceptées sont"nearest","nearest-exact","bilinear","bicubic"ou"area". - batch_size (
int, facultatif, par défaut1) — Taille du lot ; ne concerne que la configuration deensemble_sizeou le passage d'un tenseur d'images. - ensembling_kwargs (
dict, facultatif, défautNone) — Dictionnaire supplémentaire avec des arguments pour un contrôle précis de l'ensembling. Les options suivantes sont disponibles :- reduction (
str, facultatif, par défaut"median") : Définit la fonction d'ensembling appliquée à chaque position de pixel, peut être soit"median"soit"mean". - regularizer_strength (
float, facultatif, valeur par défaut0.02) : Intensité du régularisateur qui ramène les prédictions alignées vers l'intervalle unitaire de 0 à 1. - max_iter (
int, facultatif, valeur par défaut2) : Nombre maximal d'étapes du solveur d'alignement. Reportez-vous à la fonctionscipy.optimize.minimize, argumentoptions. - tol (
float, facultatif, par défaut1e-3) : Tolérance du solveur d'alignement. Le solveur s'arrête lorsque la tolérance est atteinte. - max_res (
int, facultatif, par défautNone) : Résolution à laquelle l’alignement est effectué ;Nonecorrespond àprocessing_resolution.
- reduction (
- latents (
torch.Tensoroulist[torch.Tensor], facultatif, par défautNone) — Tenseurs de bruit latent pour remplacer l’initialisation aléatoire. Ils peuvent être issus de la sortie de l’appel de fonction précédent. - generator (
torch.Generator, oulist[torch.Generator], facultatif, par défautNone) — Objet générateur de nombres aléatoires pour garantir la reproductibilité. - output_type (
str, facultatif, par défaut"np") — Format préféré des champspredictionetuncertaintyfacultatif de la sortie. Les valeurs acceptées sont :"np"(tableau numpy) ou"pt"(tenseur torch). - output_uncertainty (
bool, facultatif, par défautFalse) — Lorsqu’il est activé, le champuncertaintyde la sortie contient la carte d’incertitude prédictive, à condition que l’argumentensemble_sizesoit défini sur une valeur supérieure à 2. - output_latent (
bool, optional, defaults toFalse) — When enabled, the output’slatentfield contains the latent codes corresponding to the predictions within the ensemble. These codes can be saved, modified, and used for subsequent calls with thelatentsargument. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un MarigoldDepthOutput plutôt qu'un simple tuple.
Retourne
MarigoldDepthOutput ou tuple
Si return_dict est True, MarigoldDepthOutput est renvoyé, sinon un
tuple est renvoyé dont le premier élément est la prédiction, le deuxième élément est l’incertitude
(ou None) et le troisième est le latent (ou None).
Fonction appelée lors de l'appel du pipeline.
Exemples :
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
classe diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Paramètres
- prediction (
np.ndarray,torch.Tensor) — Cartes de profondeur prédites avec des valeurs comprises dans l'intervalle [0, 1]. La forme estnumimages × 1 × height × widthpourtorch.Tensorounumimages × height × width × 1pournp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Cartes d'incertitude calculées à partir de l'ensemble, avec des valeurs comprises dans l'intervalle [0, 1]. La forme estnumimages × 1 × height × widthpourtorch.Tensorounumimages × height × width × 1pournp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape isnumimages * numensemble × 4 × latentheight × latentwidth.
Classe de sortie pour le pipeline de prédiction de profondeur monoculaire Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
Paramètres
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]) : Cartes de profondeur. - val_min (
float, facultatif, valeur par défaut0.0) — Valeur minimale de la plage de profondeur visualisée. - val_max (
float, facultatif, valeur par défaut1.0) — Valeur maximale de la plage de profondeur visualisée. - color_map (
str, facultatif, par défaut"Spectral") — Carte de couleurs utilisée pour convertir une prédiction de profondeur monocanal en représentation colorée.
Visualise les cartes de profondeur, telles que les prédictions du MarigoldDepthPipeline.
Retourne : list[PIL.Image.Image] avec la visualisation des cartes de profondeur.
API d'estimation des normales Marigold
classe diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Paramètres
- unet (
UNet2DConditionModel) — U-Net conditionnel pour débruyer les latents de normales, conditionné sur les latents d'image. - vae (
AutoencoderKL) — Modèle de Variational Auto-Encoder (VAE) pour encoder et décoder des images et des prédictions vers et depuis des représentations latentes. - scheduler (
DDIMSchedulerouLCMScheduler) — Un planificateur à utiliser en combinaison avecunetpour débruyer les latents de l'image encodée. - text_encoder (
CLIPTextModel) — Encodeur de texte, pour l’incorporation de texte vide. - tokenizer (
CLIPTokenizer) — Tokeniseur CLIP. - prediction_type (
str, facultatif) — Type de prédictions effectuées par le modèle. - use_full_z_range (
bool, facultatif) — Indique si les normales prédites par ce modèle utilisent l'intégralité de la plage de la dimension Z, ou seulement sa moitié positive. - default_denoising_steps (
int, facultatif) — Le nombre minimal d’étapes de débruitage de diffusion nécessaires pour produire une prédiction de qualité raisonnable avec le modèle donné. Cette valeur doit être définie dans la configuration du modèle. Lorsque le pipeline est appelé sans définir explicitementnum_inference_steps, la valeur par défaut est utilisée. Cela est requis pour garantir des résultats raisonnables avec les différentes variantes de modèles compatibles avec le pipeline, telles que celles qui reposent sur des calendriers de débruitage très courts (LCMScheduler) et celles avec des calendriers de diffusion complets (DDIMScheduler). - default_processing_resolution (
int, facultatif) — La valeur recommandée du paramètreprocessing_resolutiondu pipeline. Cette valeur doit être définie dans la configuration du modèle. Lorsque le pipeline est appelé sans définir explicitementprocessing_resolution, la valeur par défaut est utilisée. Cela est nécessaire pour garantir des résultats raisonnables avec les différentes variantes de modèles entraînées avec des valeurs de résolution de traitement optimales variables.
Pipeline pour l'estimation des normales monoculaires à l'aide de la méthode Marigold : https://marigoldmonodepth.github.io.
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
Paramètres
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]), —list[torch.Tensor]: une image d’entrée ou des images utilisées comme entrée pour la tâche d’estimation des normales. Pour les tableaux et les tenseurs, la plage de valeurs attendue est comprise entre[0, 1]. Il est possible de passer un lot d’images en fournissant un tableau ou un tenseur à quatre dimensions. De plus, une liste d’images sous forme de tableaux ou de tenseurs à deux ou trois dimensions peut être transmise. Dans ce dernier cas, tous les éléments de la liste doivent avoir la même largeur et la même hauteur. - num_inference_steps (
int, facultatif, valeur par défautNone) — Nombre d'étapes de diffusion de débruitage lors de l'inférence. La valeur par défautNoneentraîne une sélection automatique. - ensemble_size (
int, par défaut1) — Nombre de prédictions d'ensemble. Des valeurs plus élevées entraînent des améliorations mesurables et une dégradation visuelle. - processing_resolution (
int, facultatif, valeur par défautNone) — Résolution de traitement effective. Si définie sur0, elle correspond à la dimension la plus grande de l'image d'entrée. Cela produit des prédictions plus nettes, mais peut également entraîner une perte du contexte global. La valeur par défautNonese résout à la valeur optimale issue de la configuration du modèle. - match_input_resolution (
bool, facultatif, valeur par défautTrue) — Lorsqu’activé, la prédiction de sortie est redimensionnée pour correspondre aux dimensions de l’entrée. Lorsqu’il est désactivé, le côté le plus long de la sortie sera égal àprocessing_resolution. - resample_method_input (
str, facultatif, par défaut"bilinear") — Méthode de rééchantillonnage utilisée pour redimensionner les images d'entrée versprocessing_resolution. Les valeurs acceptées sont :"nearest","nearest-exact","bilinear","bicubic"ou"area". - resample_method_output (
str, facultatif, par défaut"bilinear") — Méthode de rééchantillonnage utilisée pour redimensionner les prédictions de sortie afin de correspondre à la résolution d'entrée. Les valeurs acceptées sont"nearest","nearest-exact","bilinear","bicubic"ou"area". - batch_size (
int, facultatif, par défaut1) — Taille du lot ; ne concerne que la configuration deensemble_sizeou le passage d'un tenseur d'images. - ensembling_kwargs (
dict, facultatif, défautNone) — Dictionnaire supplémentaire avec des arguments pour un contrôle précis de l'ensembling. Les options suivantes sont disponibles :- reduction (
str, facultatif, par défaut"closest") : Définit la fonction d'ensembling appliquée à chaque position de pixel, peut être soit"closest"soit"mean".
- reduction (
- latents (
torch.Tensor, facultatif, par défautNone) — Tenseurs de bruit latent pour remplacer l’initialisation aléatoire. Ils peuvent être issus de la sortie de l’appel de fonction précédent. - generator (
torch.Generator, oulist[torch.Generator], facultatif, par défautNone) — Objet générateur de nombres aléatoires pour garantir la reproductibilité. - output_type (
str, facultatif, par défaut"np") — Format préféré des champspredictionetuncertaintyfacultatif de la sortie. Les valeurs acceptées sont :"np"(tableau numpy) ou"pt"(tenseur torch). - output_uncertainty (
bool, facultatif, par défautFalse) — Lorsqu’il est activé, le champuncertaintyde la sortie contient la carte d’incertitude prédictive, à condition que l’argumentensemble_sizesoit défini sur une valeur supérieure à 2. - output_latent (
bool, optional, defaults toFalse) — When enabled, the output’slatentfield contains the latent codes corresponding to the predictions within the ensemble. These codes can be saved, modified, and used for subsequent calls with thelatentsargument. - return_dict (
bool, facultatif, valeur par défautTrue) — Indique s'il faut retourner un MarigoldNormalsOutput plutôt qu'un simple tuple.
Retourne
MarigoldNormalsOutput ou tuple
Si return_dict est True, MarigoldNormalsOutput est renvoyé, sinon un
tuple est renvoyé dont le premier élément est la prédiction, le deuxième élément est l’incertitude
(ou None) et le troisième est le latent (ou None).
Fonction appelée lors de l'appel du pipeline.
Exemples :
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
classe diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Paramètres
- prediction (
np.ndarray,torch.Tensor) — Normales prédites avec des valeurs comprises dans l'intervalle [-1, 1]. La forme estnumimages × 3 × height × widthpourtorch.Tensorounumimages × height × width × 3pournp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Cartes d'incertitude calculées à partir de l'ensemble, avec des valeurs comprises dans l'intervalle [0, 1]. La forme estnumimages × 1 × height × widthpourtorch.Tensorounumimages × height × width × 1pournp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape isnumimages * numensemble × 4 × latentheight × latentwidth.
Classe de sortie pour le pipeline de prédiction des normales monoculaires Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
Paramètres
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Normales de surface. - flip_x (
bool, facultatif, par défautFalse) — Inverse l’axe X du repère des normales. La direction par défaut est la droite. - flip_y (
bool, facultatif, par défautFalse) — Inverse l’axe Y du repère des normales. La direction par défaut est le haut. - flip_z (
bool, facultatif, par défautFalse) — Inverse l’axe Z du repère des normales. La direction par défaut est orientée vers l’observateur.
Visualise les normales de surface, telles que les prédictions du MarigoldNormalsPipeline.
Retourne : list[PIL.Image.Image] avec la visualisation des normales de surface.
API de décomposition d'image intrinsèque Marigold
classe diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Paramètres
- unet (
UNet2DConditionModel) — U-Net conditionnel pour débruyer les latents cibles, conditionné sur le latent d'image. - vae (
AutoencoderKL) — Modèle de Variational Auto-Encoder (VAE) pour encoder et décoder des images et des prédictions vers et depuis des représentations latentes. - scheduler (
DDIMSchedulerouLCMScheduler) — Un planificateur à utiliser en combinaison avecunetpour débruyer les latents de l'image encodée. - text_encoder (
CLIPTextModel) — Encodeur de texte, pour l’incorporation de texte vide. - tokenizer (
CLIPTokenizer) — Tokeniseur CLIP. - prediction_type (
str, facultatif) — Type de prédictions effectuées par le modèle. - target_properties (
dict[str, Any], facultatif) — Propriétés des modalités prédites, telles quetarget_names, unelist[str]utilisée pour définir le nombre, l’ordre et les noms des modalités prédites, ainsi que toute autre métadonnée nécessaire à l’interprétation des prédictions. - default_denoising_steps (
int, facultatif) — Le nombre minimal d’étapes de débruitage de diffusion nécessaires pour produire une prédiction de qualité raisonnable avec le modèle donné. Cette valeur doit être définie dans la configuration du modèle. Lorsque le pipeline est appelé sans définir explicitementnum_inference_steps, la valeur par défaut est utilisée. Cela est requis pour garantir des résultats raisonnables avec les différentes variantes de modèles compatibles avec le pipeline, telles que celles qui reposent sur des calendriers de débruitage très courts (LCMScheduler) et celles avec des calendriers de diffusion complets (DDIMScheduler). - default_processing_resolution (
int, facultatif) — La valeur recommandée du paramètreprocessing_resolutiondu pipeline. Cette valeur doit être définie dans la configuration du modèle. Lorsque le pipeline est appelé sans définir explicitementprocessing_resolution, la valeur par défaut est utilisée. Cela est nécessaire pour garantir des résultats raisonnables avec les différentes variantes de modèles entraînées avec des valeurs de résolution de traitement optimales variables.
Pipeline pour la décomposition d'images intrinsèques (IID) à l'aide de la méthode Marigold : https://marigoldcomputervision.github.io.
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
Paramètres
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray]),list[torch.Tensor]: une image d’entrée ou des images d’entrée utilisées comme entrée pour la tâche de décomposition intrinsèque. Pour les tableaux et les tenseurs, la plage de valeurs attendue est comprise entre[0, 1]. Il est possible de passer un lot d’images en fournissant un tableau ou un tenseur à quatre dimensions. De plus, une liste d’images de tableaux ou de tenseurs à deux ou trois dimensions peut être transmise. Dans ce dernier cas, tous les éléments de la liste doivent avoir la même largeur et la même hauteur. - num_inference_steps (
int, facultatif, valeur par défautNone) — Nombre d'étapes de diffusion de débruitage lors de l'inférence. La valeur par défautNoneentraîne une sélection automatique. - ensemble_size (
int, par défaut1) — Nombre de prédictions d'ensemble. Des valeurs plus élevées entraînent des améliorations mesurables et une dégradation visuelle. - processing_resolution (
int, facultatif, valeur par défautNone) — Résolution de traitement effective. Si définie sur0, elle correspond à la dimension la plus grande de l'image d'entrée. Cela produit des prédictions plus nettes, mais peut également entraîner une perte du contexte global. La valeur par défautNonese résout à la valeur optimale issue de la configuration du modèle. - match_input_resolution (
bool, facultatif, valeur par défautTrue) — Lorsqu’activé, la prédiction de sortie est redimensionnée pour correspondre aux dimensions de l’entrée. Lorsqu’il est désactivé, le côté le plus long de la sortie sera égal àprocessing_resolution. - resample_method_input (
str, facultatif, par défaut"bilinear") — Méthode de rééchantillonnage utilisée pour redimensionner les images d'entrée versprocessing_resolution. Les valeurs acceptées sont :"nearest","nearest-exact","bilinear","bicubic"ou"area". - resample_method_output (
str, facultatif, par défaut"bilinear") — Méthode de rééchantillonnage utilisée pour redimensionner les prédictions de sortie afin de correspondre à la résolution d'entrée. Les valeurs acceptées sont"nearest","nearest-exact","bilinear","bicubic"ou"area". - batch_size (
int, facultatif, par défaut1) — Taille du lot ; ne concerne que la configuration deensemble_sizeou le passage d'un tenseur d'images. - ensembling_kwargs (
dict, facultatif, défautNone) — Dictionnaire supplémentaire avec des arguments pour un contrôle précis de l'ensembling. Les options suivantes sont disponibles :- reduction (
str, facultatif, par défaut"median") : Définit la fonction d'ensembling appliquée à chaque position de pixel, peut être soit"median"soit"mean".
- reduction (
- latents (
torch.Tensor, facultatif, par défautNone) — Tenseurs de bruit latent pour remplacer l’initialisation aléatoire. Ils peuvent être issus de la sortie de l’appel de fonction précédent. - generator (
torch.Generator, oulist[torch.Generator], facultatif, par défautNone) — Objet générateur de nombres aléatoires pour garantir la reproductibilité. - output_type (
str, facultatif, par défaut"np") — Format préféré des champspredictionetuncertaintyfacultatif de la sortie. Les valeurs acceptées sont :"np"(tableau numpy) ou"pt"(tenseur torch). - output_uncertainty (
bool, facultatif, par défautFalse) — Lorsqu’il est activé, le champuncertaintyde la sortie contient la carte d’incertitude prédictive, à condition que l’argumentensemble_sizesoit défini sur une valeur supérieure à 2. - output_latent (
bool, optional, defaults toFalse) — When enabled, the output’slatentfield contains the latent codes corresponding to the predictions within the ensemble. These codes can be saved, modified, and used for subsequent calls with thelatentsargument. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un MarigoldIntrinsicsOutput plutôt qu'un simple tuple.
Retourne
MarigoldIntrinsicsOutput ou tuple
Si return_dict est True, MarigoldIntrinsicsOutput est renvoyé, sinon un
tuple est renvoyé dont le premier élément est la prédiction, le deuxième élément est l’incertitude
(ou None) et le troisième est le latent (ou None).
Fonction appelée lors de l'appel du pipeline.
Exemples :
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")classe diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Paramètres
- prediction (
np.ndarray,torch.Tensor) — Intrinsèques d’image prédites, avec des valeurs comprises dans l’intervalle [0, 1]. La forme est(numimages * numtargets) × 3 × height × widthpourtorch.Tensorou(numimages * numtargets) × height × width × 3pournp.ndarray, oùnumtargetscorrespond au nombre de modalités cibles prédites de la décomposition intrinsèque de l’image. - uncertainty (
None,np.ndarray,torch.Tensor) — Cartes d'incertitude calculées à partir de l'ensemble, avec des valeurs comprises dans l'intervalle [0, 1]. La forme est(numimages * numtargets) × 3 × height × widthpourtorch.Tensorou(numimages * numtargets) × height × width × 3pournp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape is(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
Classe de sortie pour le pipeline de décomposition d'image intrinsèque de Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dict[str, typing.Any]color_map: str | dict[str, str] = 'binary' )
Paramètres
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Décomposition d'image intrinsèque. - target_properties (
dict[str, Any]) — Propriétés de décomposition. Entrées attendues :target_names: list[str]et un dictionnaire avec les clésprediction_space: str,sub_target_names: list[str | Null](doit contenir 3 entrées, null pour les modalités manquantes),up_to_scale: bool, une pour chaque cible et sous-cible. - color_map (
str | dict[str, str], facultatif, par défaut"Spectral") — Carte de couleurs utilisée pour convertir des prédictions monocanaux en représentations colorées. Lorsqu'un dictionnaire est transmis, chaque modalité peut être colorée avec sa propre carte de couleurs.
Visualise la décomposition d'image intrinsèque, par exemple les prédictions du MarigoldIntrinsicsPipeline.
Retourne : list[dict[str, PIL.Image.Image]] avec la visualisation de la décomposition d'image intrinsèque.