
Diffusers documentation
Marigold Visão Computacional
Marigold Visão Computacional
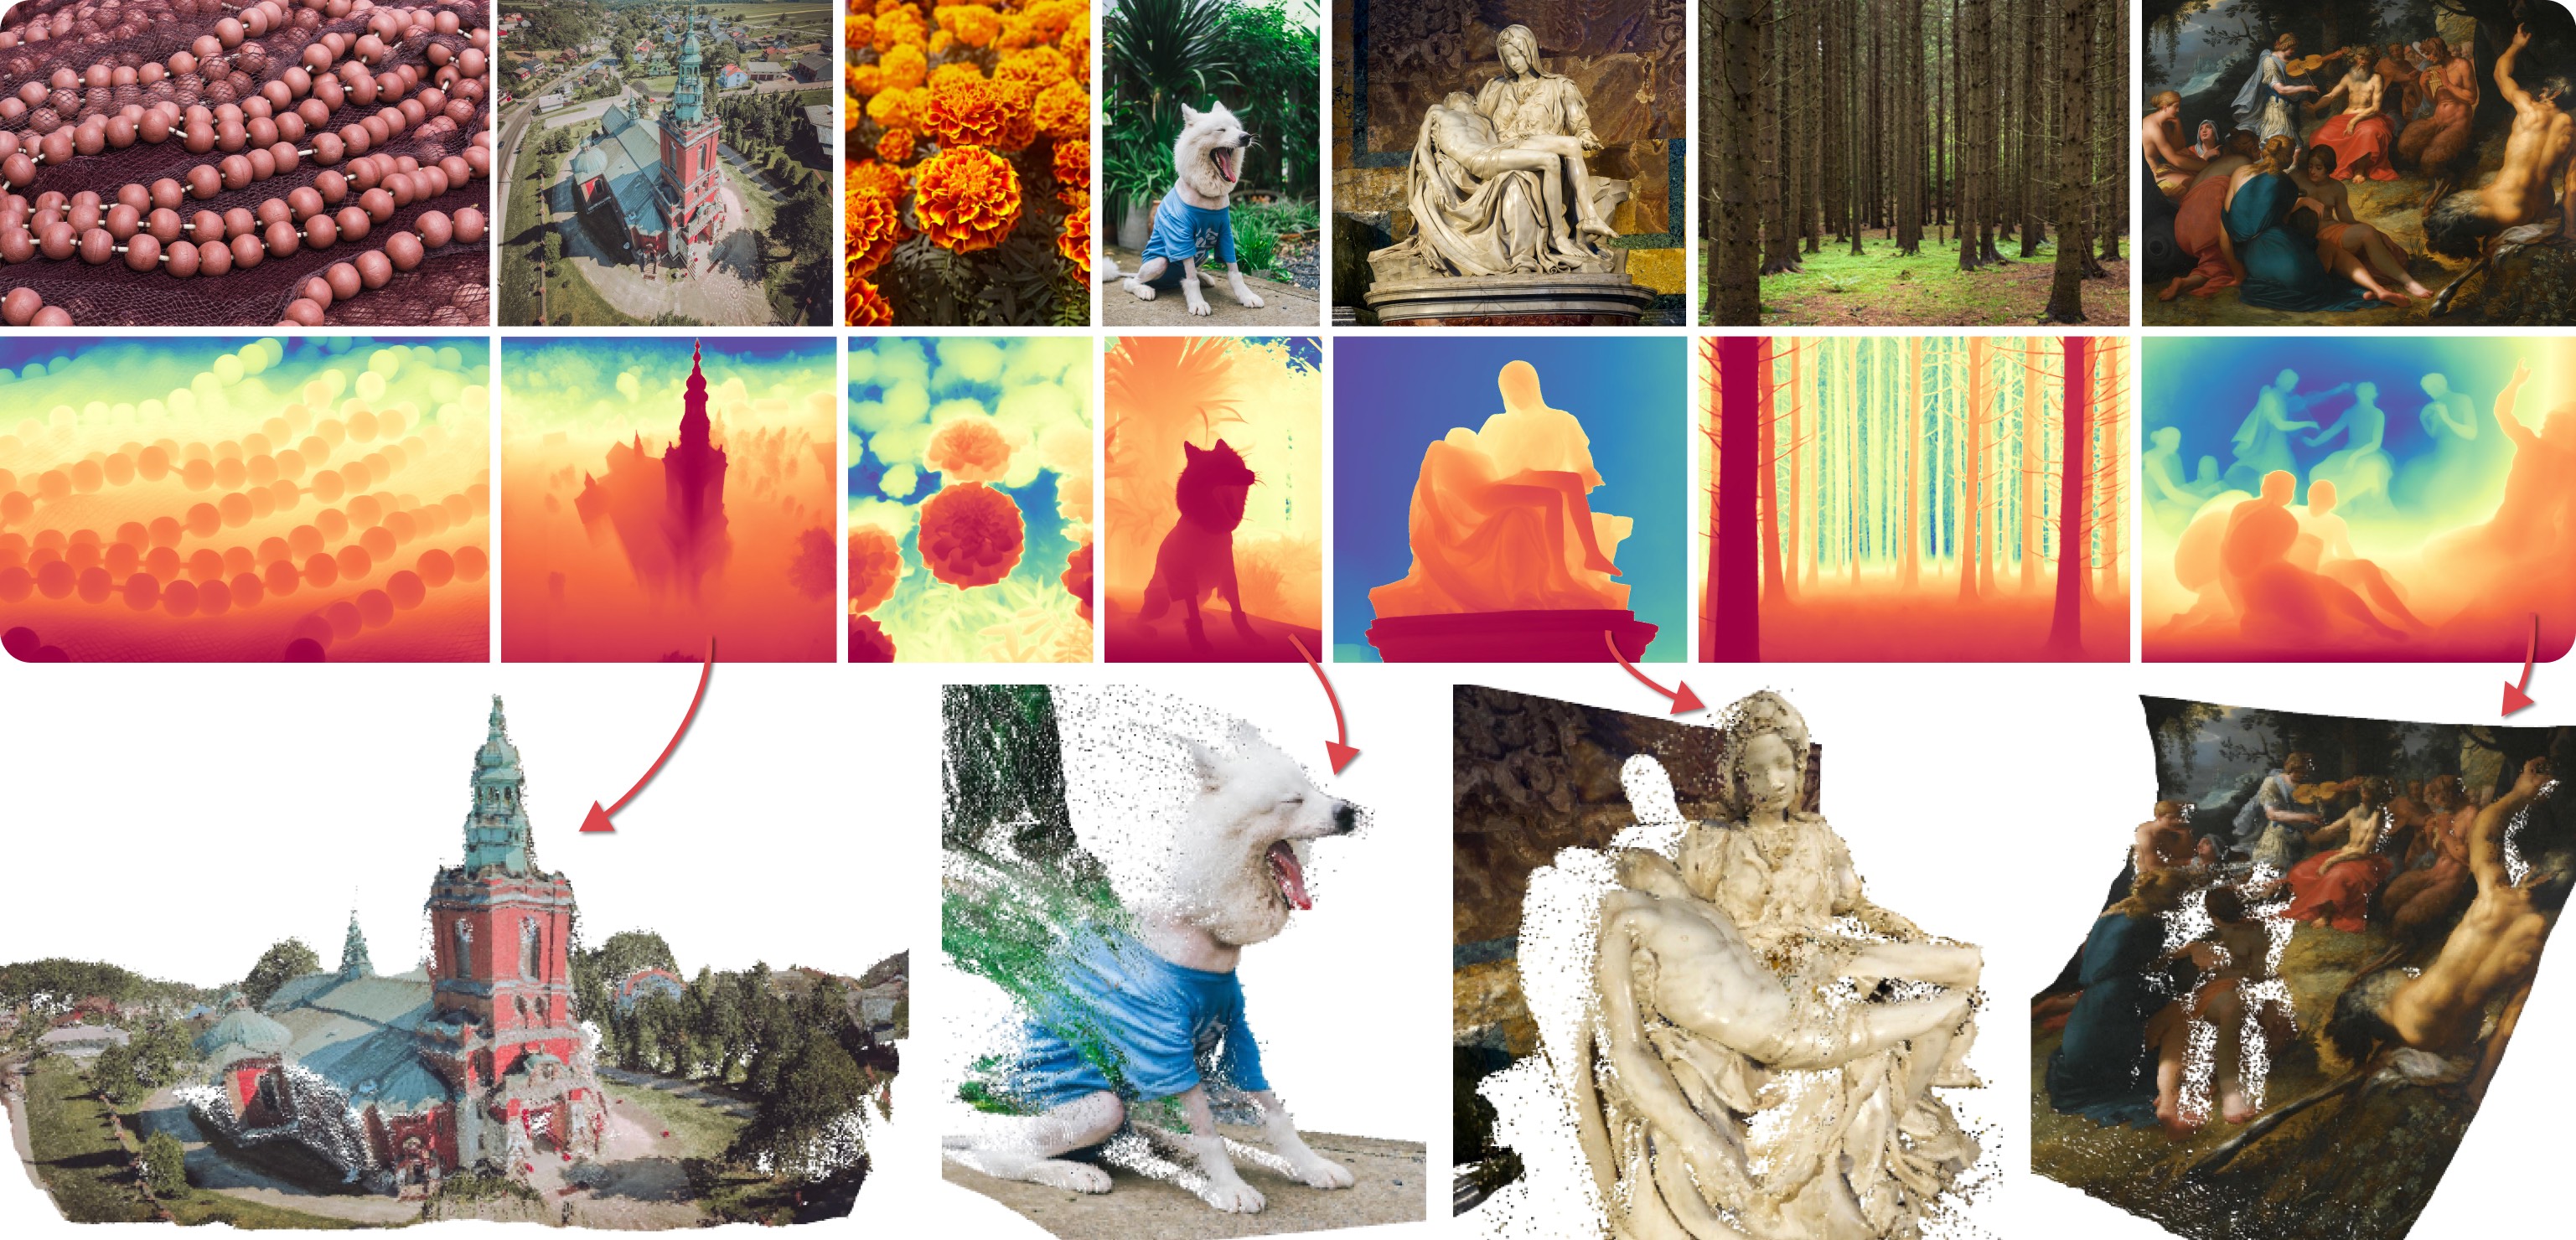
Marigold foi proposto em Repurposing Diffusion-Based Image Generators for Monocular Depth Estimation, um paper Oral do CVPR 2024 de Bingxin Ke, Anton Obukhov, Shengyu Huang, Nando Metzger, Rodrigo Caye Daudt e Konrad Schindler. A ideia central é reaproveitar o prior generativo dos Text-to-Image Latent Diffusion Models (LDMs) para tarefas tradicionais de visão computacional. Essa abordagem foi explorada por meio do fine-tuning do Stable Diffusion para Monocular Depth Estimation, conforme demonstrado no teaser acima.
Marigold foi posteriormente estendido no artigo de acompanhamento, Marigold: Affordable Adaptation of Diffusion-Based Image Generators for Image Analysis, autorado por Bingxin Ke, Kevin Qu, Tianfu Wang, Nando Metzger, Shengyu Huang, Bo Li, Anton Obukhov e Konrad Schindler. Este trabalho expandiu o Marigold para suportar novas modalidades, como Surface Normals e Intrinsic Image Decomposition (IID), introduziu um protocolo de treinamento para Latent Consistency Models (LCM) e demonstrou a capacidade de processamento em High-Resolution (HR).
Os modelos iniciais do Marigold (
v1-0e anteriores) foram otimizados para os melhores resultados com pelo menos 10 etapas de inferência. Os modelos LCM foram desenvolvidos posteriormente para permitir inferência de alta qualidade em apenas 1 a 4 etapas. Os modelos Marigoldv1-1e posteriores usam o agendador DDIM para alcançar resultados ótimos em tão poucas quanto 1 a 4 etapas.
Pipelines Disponíveis
Cada pipeline é adaptado para uma tarefa específica de visão computacional, processando uma imagem RGB de entrada e gerando uma previsão correspondente. Atualmente, as seguintes tarefas de visão computacional estão implementadas:
| Pipeline | Pontos de verificação de modelos recomendados | Spaces (Aplicativos Interativos) | Modalidades previstas |
|---|---|---|---|
| MarigoldDepthPipeline | prs-eth/marigold-depth-v1-1 | Estimativa de Profundidade | Profundidade, Disparidade |
| MarigoldNormalsPipeline | prs-eth/marigold-normals-v1-1 | Estimação de Normais de Superfície | Normais de superfície |
| MarigoldIntrinsicsPipeline | prs-eth/marigold-iid-appearance-v1-1, prs-eth/marigold-iid-lighting-v1-1 | Decomposição de Imagem Intrínseca | Albedo, Materiais, Iluminação |
Checkpoints Disponíveis
Todos os checkpoints originais estão disponíveis sob a organização PRS-ETH no Hugging Face. Eles foram projetados para uso com pipelines de diffusers e o original codebase, que também pode ser usado para treinar novos checkpoints de modelos. A seguir, há um resumo dos checkpoints recomendados, todos os quais produzem resultados confiáveis com 1 a 4 etapas.
| Checkpoint | Modalidade | Comentário |
|---|---|---|
| prs-eth/marigold-depth-v1-1 | Profundidade | A predição de profundidade invariante por afinidade atribui a cada pixel um valor entre 0 (plano próximo) e 1 (plano distante), sendo ambos os planos determinados pelo modelo durante a inferência. |
| prs-eth/marigold-normals-v0-1 | Normais | As previsões de normais de superfície são vetores 3D de comprimento unitário no espaço de tela da câmera, com valores no intervalo de -1 a 1. |
| prs-eth/marigold-iid-appearance-v1-1 | Intrínsecos | A decomposição do InteriorVerse é composta por Albedo e duas propriedades de material BRDF: Roughness e Metallicity. |
| prs-eth/marigold-iid-lighting-v1-1 | Intrínsecos | Decomposição do HyperSim de uma imagem é composta por Albedo $A$, Sombreamento difuso $S$ e Resíduo não-difuso $R$: $I = A*S+R$. |
Certifique-se de consultar o guia de Schedulers para aprender a explorar o compromisso entre a velocidade e a qualidade do scheduler, e veja a seção reutilização de componentes entre pipelines para aprender a carregar eficientemente os mesmos componentes em vários pipelines. Além disso, para saber mais sobre a redução do uso de memória deste pipeline, consulte a seção ["Reduce memory usage"] aqui.
Os pipelines do Marigold foram projetados e testados com o scheduler embutido no checkpoint do modelo. O número ideal de etapas de inferência varia conforme o scheduler, não havendo um valor universal que funcione melhor em todos os casos. Para acomodar isso, o parâmetro
num_inference_stepsno método__call__do pipeline tem como padrãoNone(veja a referência da API). A menos que seja definido explicitamente, ele herda o valor do campodefault_denoising_stepsno arquivo de configuração do checkpoint (model_index.json). Isso garante previsões de alta qualidade ao invocar o pipeline apenas com o argumentoimage.
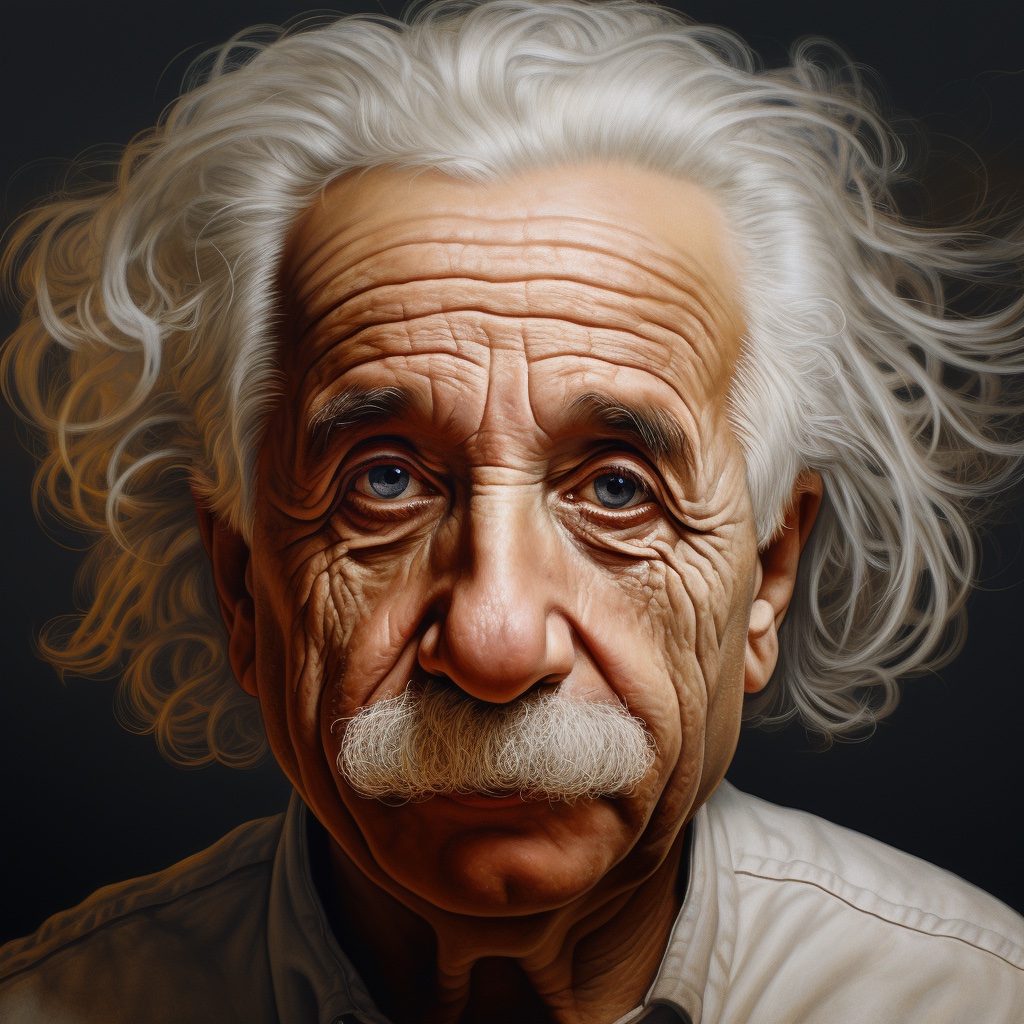
Os exemplos abaixo são fornecidos principalmente para predição de profundidade, mas podem ser aplicados universalmente a outras modalidades suportadas. Apresentamos as predições usando a mesma imagem de entrada de Albert Einstein gerada pelo Midjourney. Isso facilita a comparação das visualizações das predições entre as diversas modalidades e checkpoints.
Previsão de Profundidade
Para obter uma previsão de profundidade, carregue o checkpoint prs-eth/marigold-depth-v1-1 no MarigoldDepthPipeline,
envie a imagem pelo pipeline e salve as previsões:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(image)

vis = pipe.image_processor.visualize_depth(depth.prediction)
vis[0].save("einstein_depth.png")

depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
depth_16bit[0].save("einstein_depth_16bit.png")
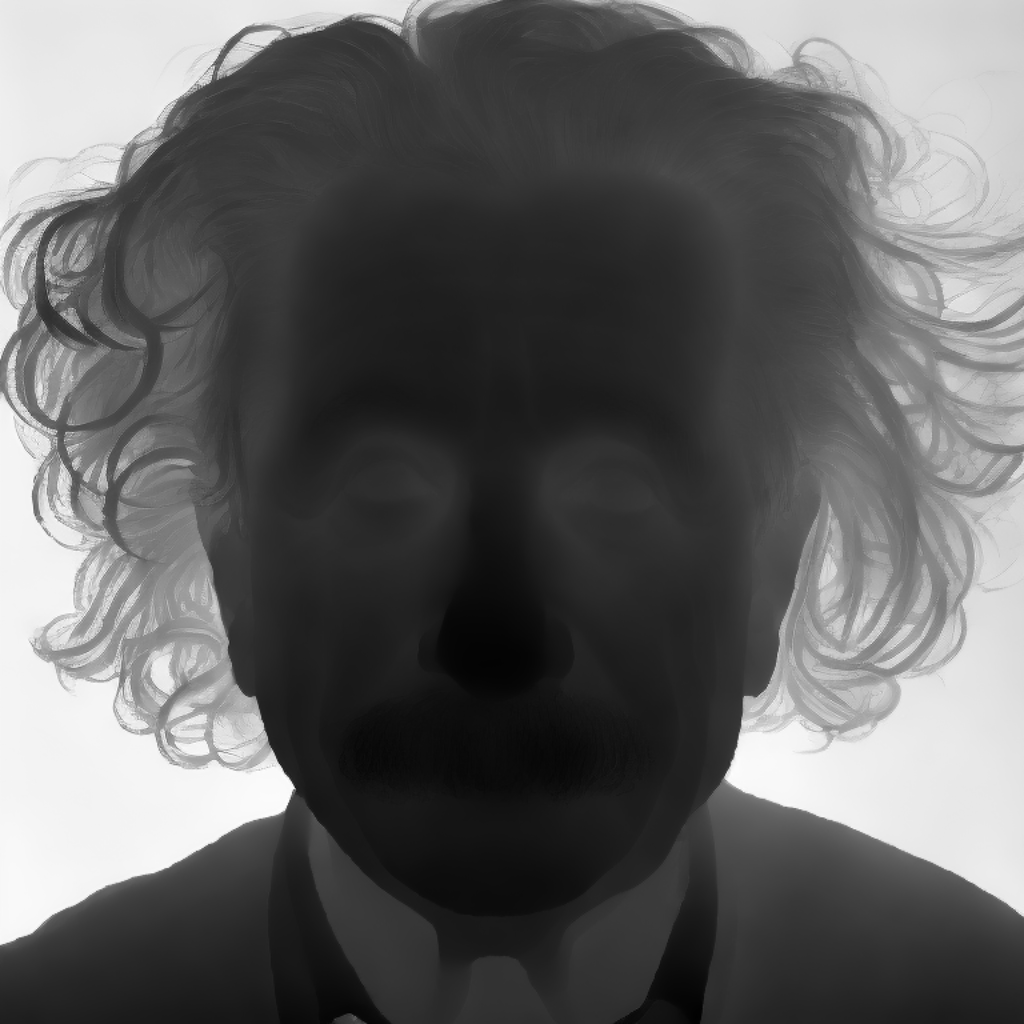
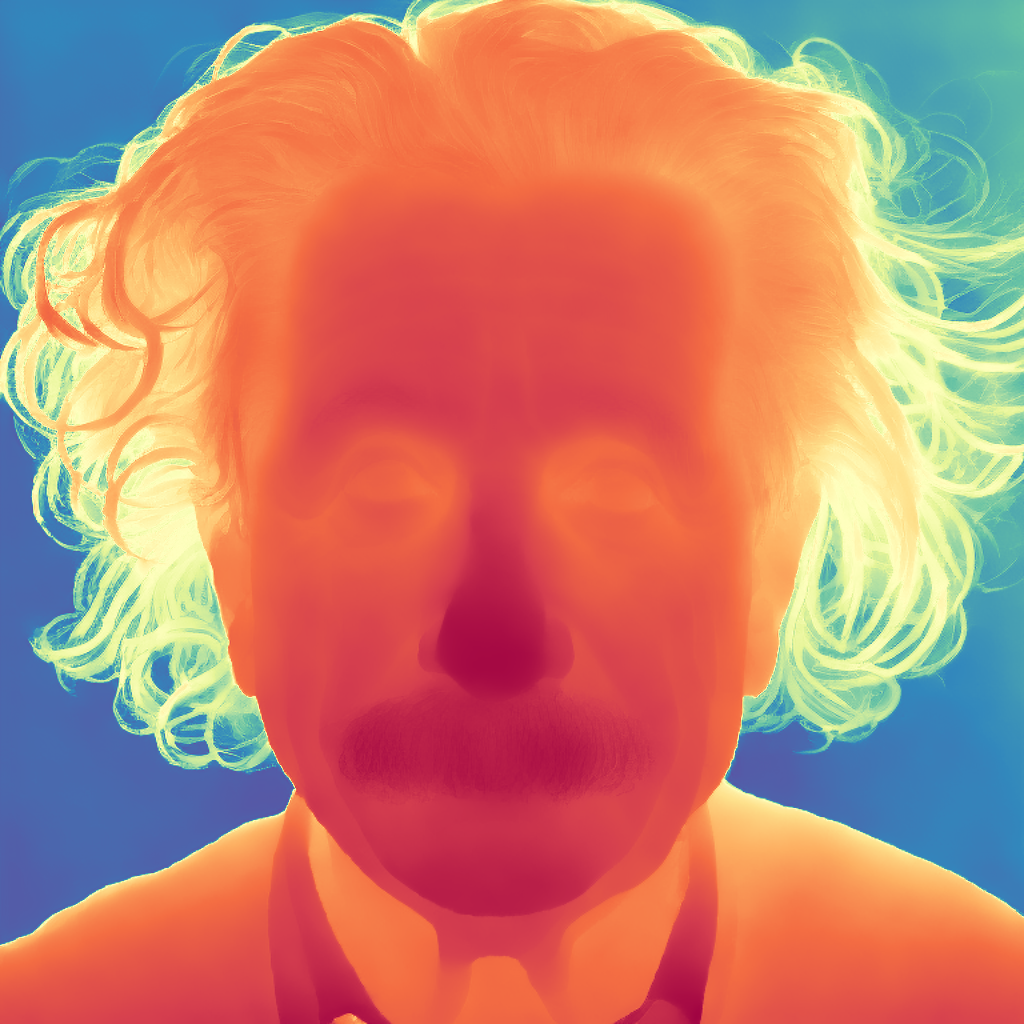
A função visualize_depth() aplica um dos colormaps do matplotlib (Spectral por padrão) para mapear os valores de pixels previstos de uma faixa de profundidade de canal único [0, 1] para uma imagem RGB.
Com o colormap Spectral, pixels com profundidade próxima são pintados de vermelho, e pixels distantes são azuis.
O arquivo PNG de 16 bits armazena os valores de canal único mapeados linearmente da faixa [0, 1] para [0, 65535].
Abaixo estão as previsões brutas e as visualizadas. As áreas mais escuras e próximas (bigode) são mais fáceis de distinguir na
visualização.
Estimação de Normais de Superfície
Carregue o checkpoint prs-eth/marigold-normals-v1-1 no MarigoldNormalsPipeline, processe a imagem pelo pipeline e salve as previsões:
import diffusers
import torch

pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
    "prs-eth/marigold-normals-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

normals = pipe(image)

vis = pipe.image_processor.visualize_normals(normals.prediction)
vis[0].save("einstein_normals.png")
A função visualize_normals() mapeia a predição tridimensional, com valores de pixel no intervalo [-1, 1], para uma imagem RGB.
A função de visualização suporta a inversão dos eixos dos vetores normais da superfície para tornar a visualização compatível com outras
escolhas do sistema de referência.
Conceitualmente, cada pixel é pintado de acordo com o vetor normal da superfície no sistema de referência, em que o eixo X
aponta para a direita, o eixo Y aponta para cima e o eixo Z aponta para o observador.
Abaixo está a predição visualizada:

Neste exemplo, a ponta do nariz quase certamente tem um ponto na superfície, no qual o vetor normal da superfície aponta
diretamente para o observador, o que significa que suas coordenadas são [0, 0, 1].
Esse vetor é mapeado para o RGB [128, 128, 255], que corresponde à cor violeta-azulada.
Da mesma forma, uma normal de superfície na bochecha, na parte direita da imagem, tem um componente X grande, o que aumenta a
matiz vermelha.
Pontos nos ombros apontando para cima com um grande Y promovem a cor verde.
Decomposição de Imagem Intrínseca
Marigold fornece dois modelos para Decomposição de Imagem Intrínseca (IID): “Appearance” e “Lighting”. Cada modelo produz mapas de Albedo, derivados das anotações de InteriorVerse e Hypersim, respectivamente.
- O modelo “Appearance” também estima as propriedades de Material: Roughness e Metallicity.
- O modelo “Lighting” gera o Sombreamento Difuso e o Resíduo Não-difuso.
Aqui está o código de exemplo que salva as previsões feitas pelo modelo “Appearance”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["roughness"].save("einstein_roughness.png")
vis[0]["metallicity"].save("einstein_metallicity.png")
Outro exemplo demonstrando as previsões feitas pelo modelo “Lighting”:
import diffusers
import torch

pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
    "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

intrinsics = pipe(image)

vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
vis[0]["albedo"].save("einstein_albedo.png")
vis[0]["shading"].save("einstein_shading.png")
vis[0]["residual"].save("einstein_residual.png")
Ambos os modelos compartilham o mesmo pipeline, ao mesmo tempo em que suportam diferentes tipos de decomposição.
A parametrização exata da decomposição (por exemplo, espaço sRGB vs. espaço linear) é armazenada no dicionário pipe.target_properties, que é passado para a função visualize_intrinsics().
Abaixo estão alguns exemplos que mostram as saídas de decomposição previstas. Todas as modalidades podem ser inspecionadas no Space Intrinsic Image Decomposition.


Acelerando a inferência
Os trechos de início rápido acima já estão otimizados para qualidade e velocidade, carregando o checkpoint, utilizando a variante fp16 de pesos e computação, e executando o número padrão (4) de etapas de difusão de desruido.
O primeiro passo para acelerar a inferência, às custas da qualidade da previsão, é reduzir as etapas de difusão de desruido ao mínimo:
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=1)
Com essa alteração, a chamada pipe é concluída em 280ms em uma GPU RTX 3090.
Internamente, a imagem de entrada é primeiro codificada usando o codificador VAE do Stable Diffusion, seguida por uma única etapa de desruidamento
executada pela U-Net.
Por fim, o latente da previsão é decodificado com o decodificador VAE para o espaço de pixels.
Nessa configuração, duas das três chamadas de módulos são dedicadas à conversão entre os espaços de pixels e latentes do LDM.
Como o espaço latente do Marigold é compatível com o Stable Diffusion 2.0, a inferência pode ser acelerada em mais de 3x,
reduzindo o tempo de chamada para 85ms em uma RTX 3090, ao usar um substituto leve do VAE do SD.
Observe que o uso de um VAE leve pode reduzir ligeiramente a qualidade visual das previsões.
  import diffusers
  import torch

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
+     "madebyollin/taesd", dtype=torch.float16
+ ).cuda()

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Até agora, otimizamos o número de passos de difusão e os componentes do modelo. As operações de autoatenção representam uma parte significativa dos cálculos. Acelerar essas operações pode ser feito usando um processador de atenção mais eficiente:
  import diffusers
  import torch
+ from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

+ pipe.vae.set_attn_processor(AttnProcessor2_0())
+ pipe.unet.set_attn_processor(AttnProcessor2_0())

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Por fim, conforme sugerido em Otimizações, habilitar torch.compile pode aprimorar ainda mais o desempenho, dependendo do hardware de destino.
No entanto, a compilação gera um sobrecusto significativo durante a primeira invocação do pipeline, tornando-a benéfica apenas quando a mesma instância do pipeline é chamada repetidamente, como dentro de um loop.
  import diffusers
  import torch
  from diffusers.models.attention_processor import AttnProcessor2_0

  pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
      "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
  ).to("cuda")  # or "mps", "xpu", "cpu"

  pipe.vae.set_attn_processor(AttnProcessor2_0())
  pipe.unet.set_attn_processor(AttnProcessor2_0())

+ pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

  depth = pipe(image, num_inference_steps=1)
Maximizando a Precisão e Ensembling
Os pipelines do Marigold possuem um mecanismo de ensembling embutido que combina múltiplas previsões de diferentes latentes aleatórios.
Essa é uma abordagem de força bruta para melhorar a precisão das previsões, aproveitando a natureza generativa da difusão.
O caminho de ensembling é ativado automaticamente quando o argumento ensemble_size é definido com um valor maior ou igual a 3.
Ao buscar a máxima precisão, faz sentido ajustar num_inference_steps simultaneamente com ensemble_size.
Os valores recomendados variam entre checkpoints, mas dependem principalmente do tipo de scheduler.
O efeito do ensembling é particularmente bem observado com normais de superfície:
  import diffusers

  pipe = diffusers.MarigoldNormalsPipeline.from_pretrained("prs-eth/marigold-normals-v1-1").to("cuda")  # or "mps", "xpu", "cpu"

  image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

- depth = pipe(image)
+ depth = pipe(image, num_inference_steps=10, ensemble_size=5)

  vis = pipe.image_processor.visualize_normals(depth.prediction)
vis[0].save("einstein_normals.png") 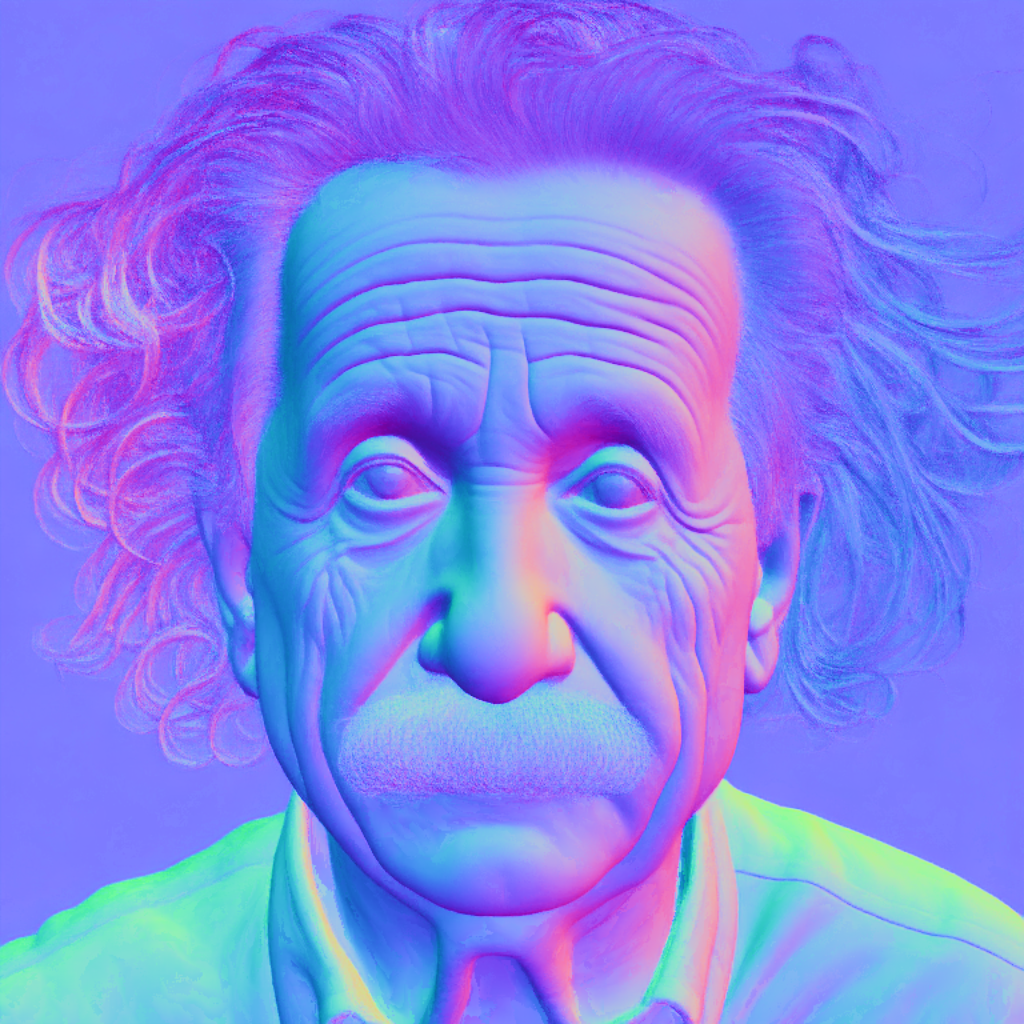
Como pode ser observado, todas as áreas com estruturas de granulação fina, como o cabelo, apresentaram previsões mais conservadoras e, em média, mais corretas. Tal resultado é mais adequado para tarefas de nível inferior sensíveis à precisão, como a reconstrução 3D.
Processamento de Vídeo Quadro a Quadro com Consistência Temporal
Devido à natureza generativa do Marigold, cada previsão é única e definida pelo ruído aleatório amostrado para a inicialização latente. Isso se torna uma desvantagem óbvia em comparação com as redes de regressão densa de ponta a ponta tradicionais, conforme exemplificado nos vídeos a seguir:
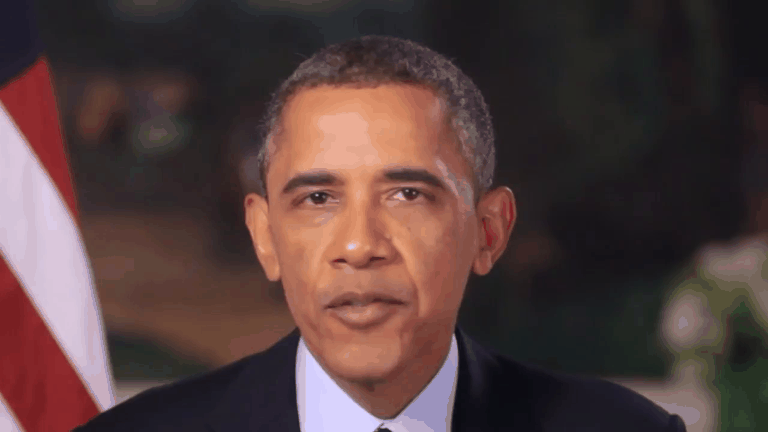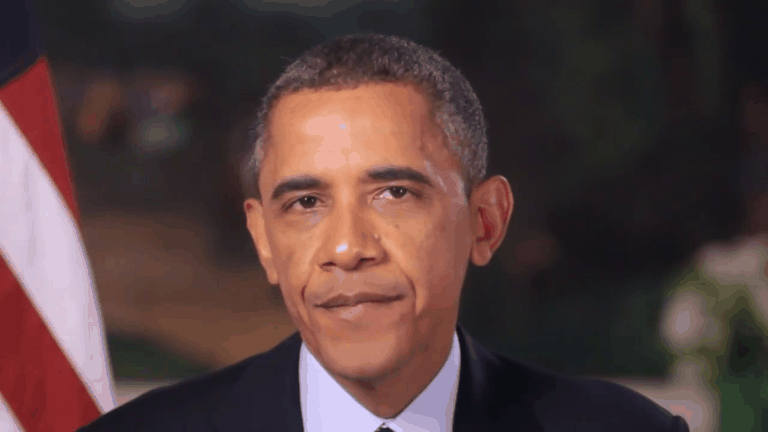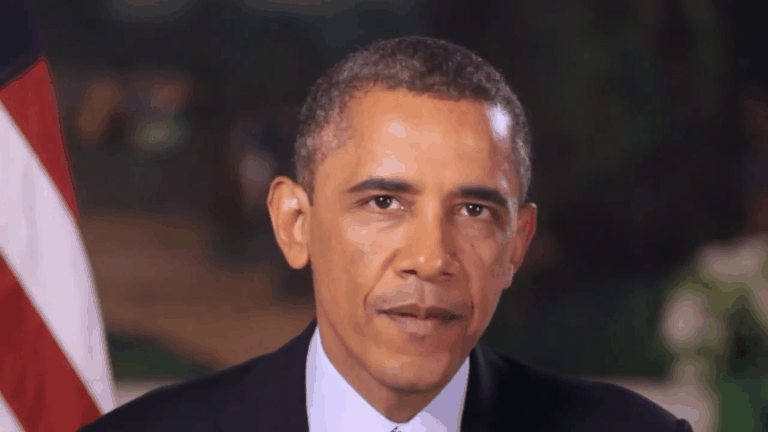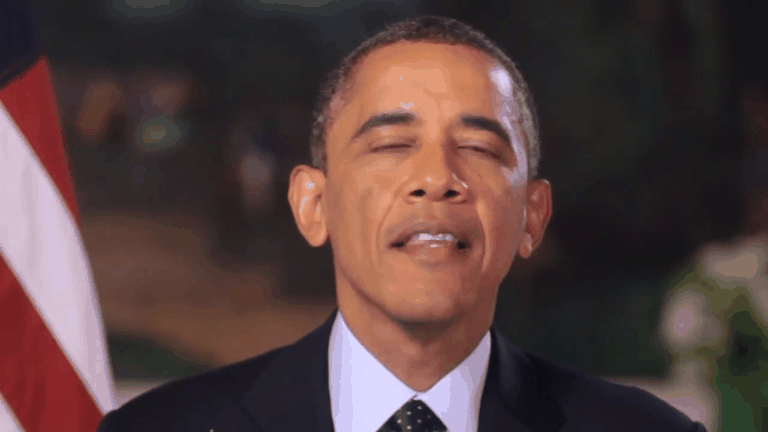
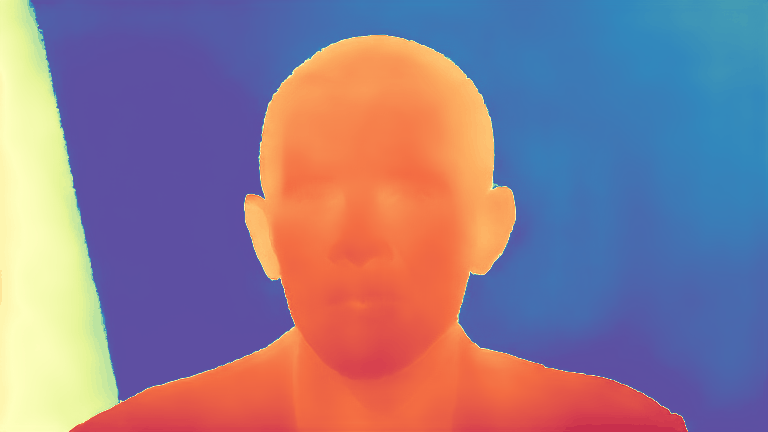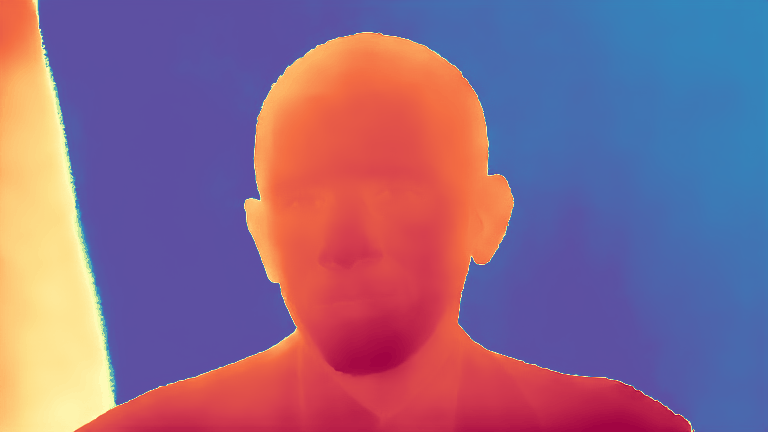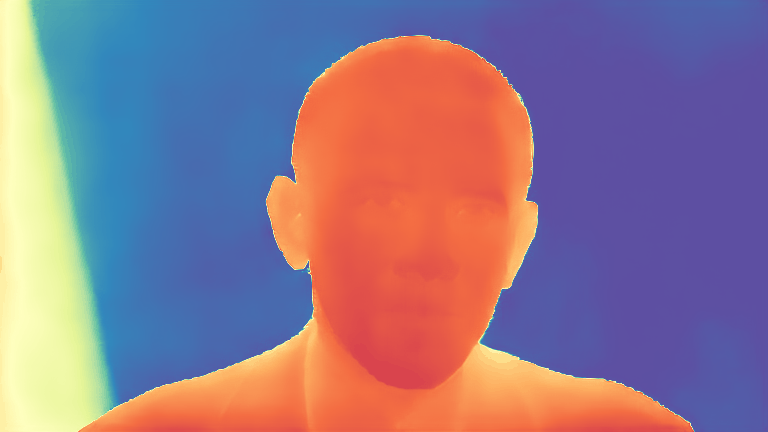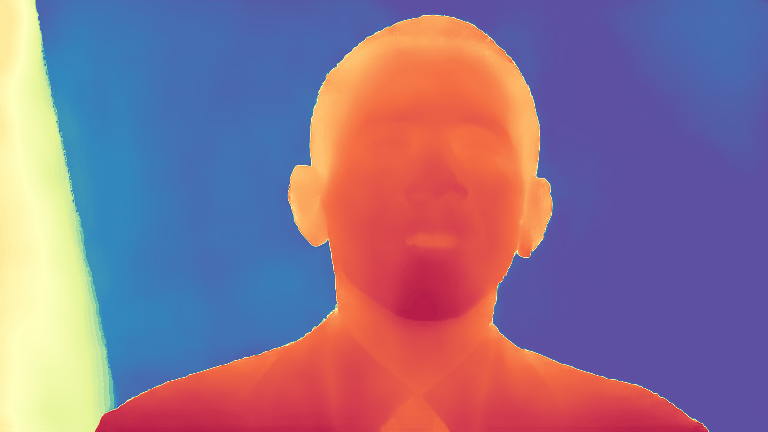
Para resolver esse problema, é possível passar o argumento latents para os pipelines, que define o ponto de partida da difusão.
Empiricamente, descobrimos que uma combinação convexa do ruído latente do mesmo ponto de partida e do latente
correspondente à previsão do quadro anterior produz resultados suficientemente suaves, conforme implementado no trecho abaixo:
import imageio
import diffusers
import torch
from diffusers.models.attention_processor import AttnProcessor2_0
from PIL import Image
from tqdm import tqdm

device = "cuda"  # or "mps", "xpu", "cpu"
path_in = "https://huggingface.co/spaces/prs-eth/marigold-lcm/resolve/c7adb5427947d2680944f898cd91d386bf0d4924/files/video/obama.mp4"
path_out = "obama_depth.gif"

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to(device)
pipe.vae = diffusers.AutoencoderTiny.from_pretrained(
    "madebyollin/taesd", dtype=torch.float16
).to(device)
pipe.unet.set_attn_processor(AttnProcessor2_0())
pipe.vae = torch.compile(pipe.vae, mode="reduce-overhead", fullgraph=True)
pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
pipe.set_progress_bar_config(disable=True)

with imageio.get_reader(path_in) as reader:
    size = reader.get_meta_data()['size']
    last_frame_latent = None
    latent_common = torch.randn(
        (1, 4, 768 * size[1] // (8 * max(size)), 768 * size[0] // (8 * max(size)))
    ).to(device=device, dtype=torch.float16)

    out = []
    for frame_id, frame in tqdm(enumerate(reader), desc="Processing Video"):
        frame = Image.fromarray(frame)
        latents = latent_common
        if last_frame_latent is not None:
            latents = 0.9 * latents + 0.1 * last_frame_latent

        depth = pipe(
            frame,
            num_inference_steps=1,
            match_input_resolution=False,
            latents=latents,
            output_latent=True,
        )
        last_frame_latent = depth.latent
        out.append(pipe.image_processor.visualize_depth(depth.prediction)[0])

    diffusers.utils.export_to_gif(out, path_out, fps=reader.get_meta_data()['fps'])
Aqui, o processo de difusão começa a partir do latente computado fornecido.
O pipeline define output_latent=True para acessar out.latent e computa sua contribuição para a inicialização do latente do próximo quadro.
O resultado agora é muito mais estável:

Marigold para ControlNet
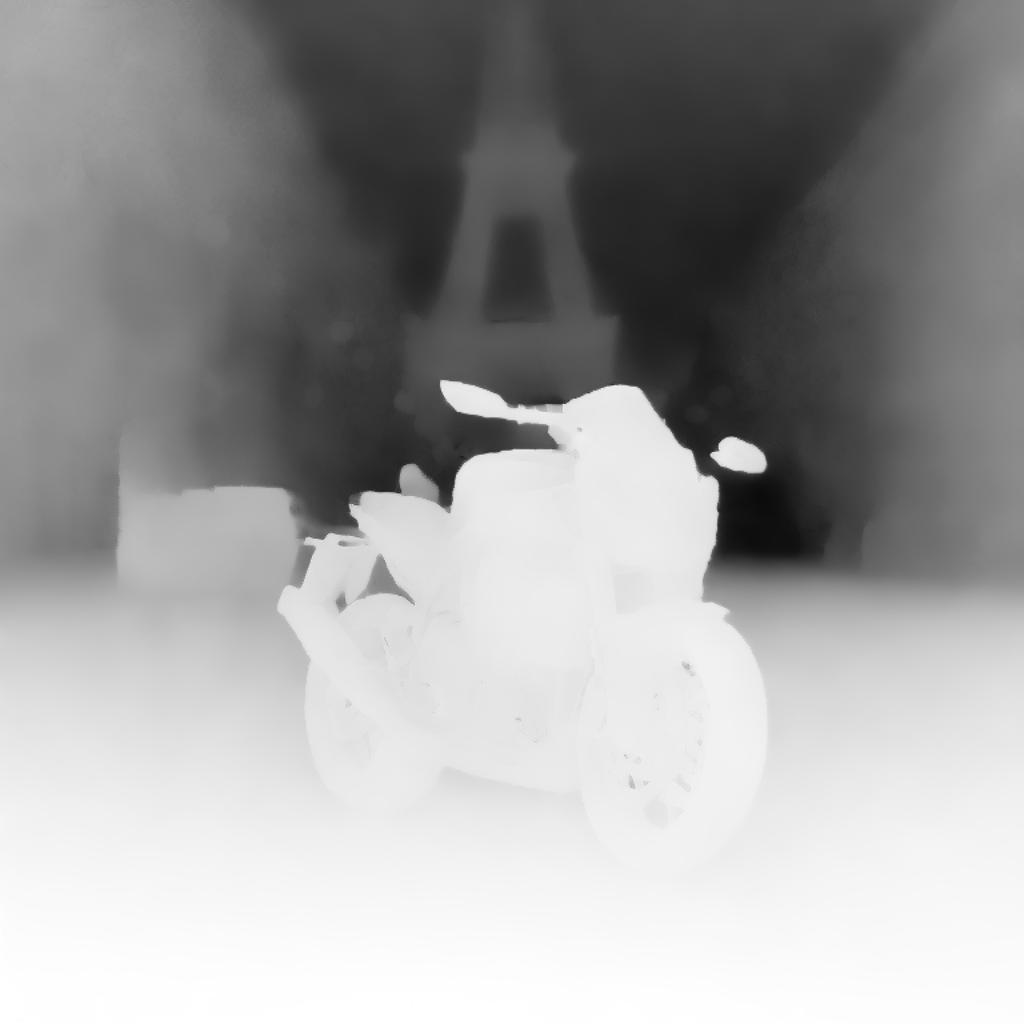
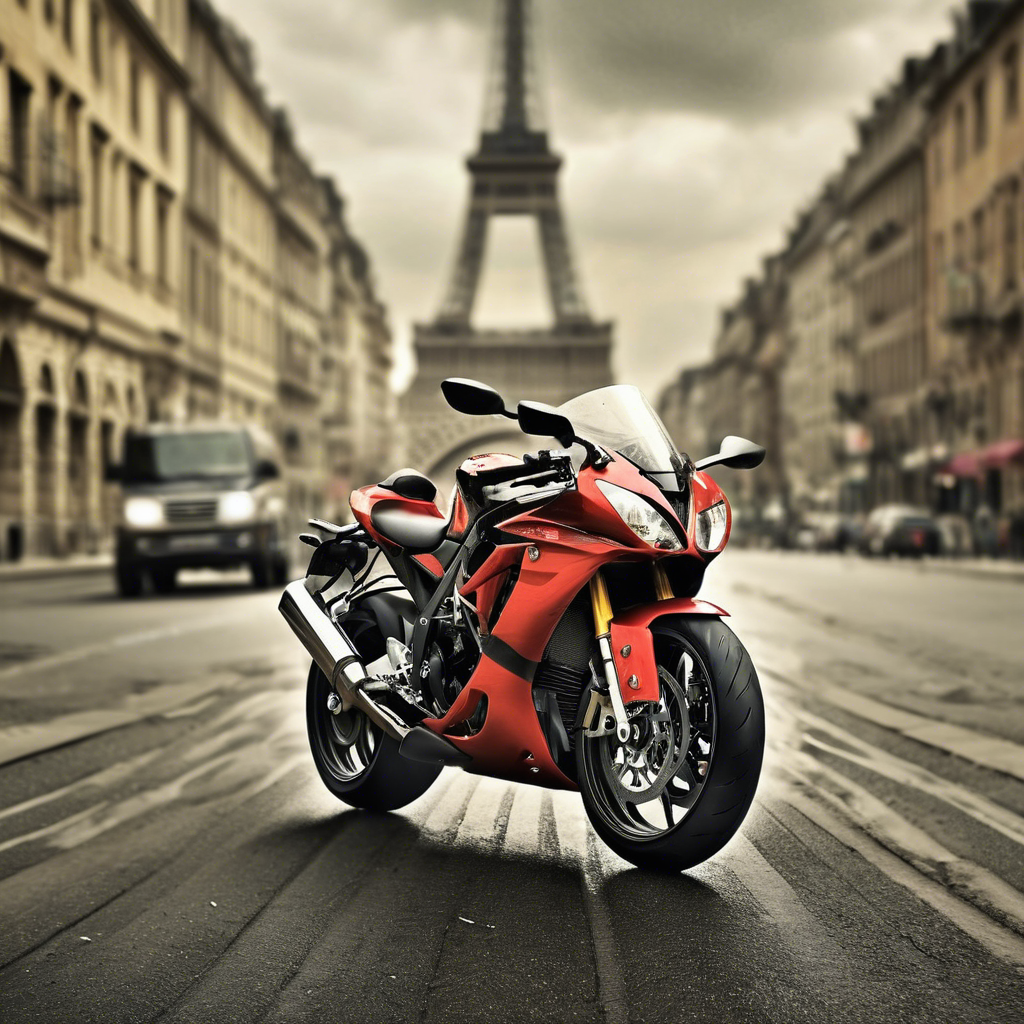
Um aplicativo muito comum para a predição de profundidade com modelos de difusão é o uso em conjunto com o ControlNet. A nitidez da profundidade desempenha um papel crucial na obtenção de resultados de alta qualidade do ControlNet. Como visto nas comparações com outros métodos acima, o Marigold se destaca nessa tarefa. O trecho de código abaixo demonstra como carregar uma imagem, calcular a profundidade e passá-la para o ControlNet em um formato compatível:
import torch
import diffusers

device = "cuda"  # or "mps", "xpu", "cpu"
generator = torch.Generator(device=device).manual_seed(2024)
image = diffusers.utils.load_image(
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/controlnet_depth_source.png"
)

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", dtype=torch.float16, variant="fp16"
).to(device)

depth_image = pipe(image, generator=generator).prediction
depth_image = pipe.image_processor.visualize_depth(depth_image, color_map="binary")
depth_image[0].save("motorcycle_controlnet_depth.png")

controlnet = diffusers.ControlNetModel.from_pretrained(
    "diffusers/controlnet-depth-sdxl-1.0", dtype=torch.float16, variant="fp16"
).to(device)
pipe = diffusers.StableDiffusionXLControlNetPipeline.from_pretrained(
    "SG161222/RealVisXL_V4.0", dtype=torch.float16, variant="fp16", controlnet=controlnet
).to(device)
pipe.scheduler = diffusers.DPMSolverMultistepScheduler.from_config(pipe.scheduler.config, use_karras_sigmas=True)

controlnet_out = pipe(
    prompt="high quality photo of a sports bike, city",
    negative_prompt="",
    guidance_scale=6.5,
    num_inference_steps=25,
    image=depth_image,
    controlnet_conditioning_scale=0.7,
    control_guidance_end=0.7,
    generator=generator,
).images
controlnet_out[0].save("motorcycle_controlnet_out.png")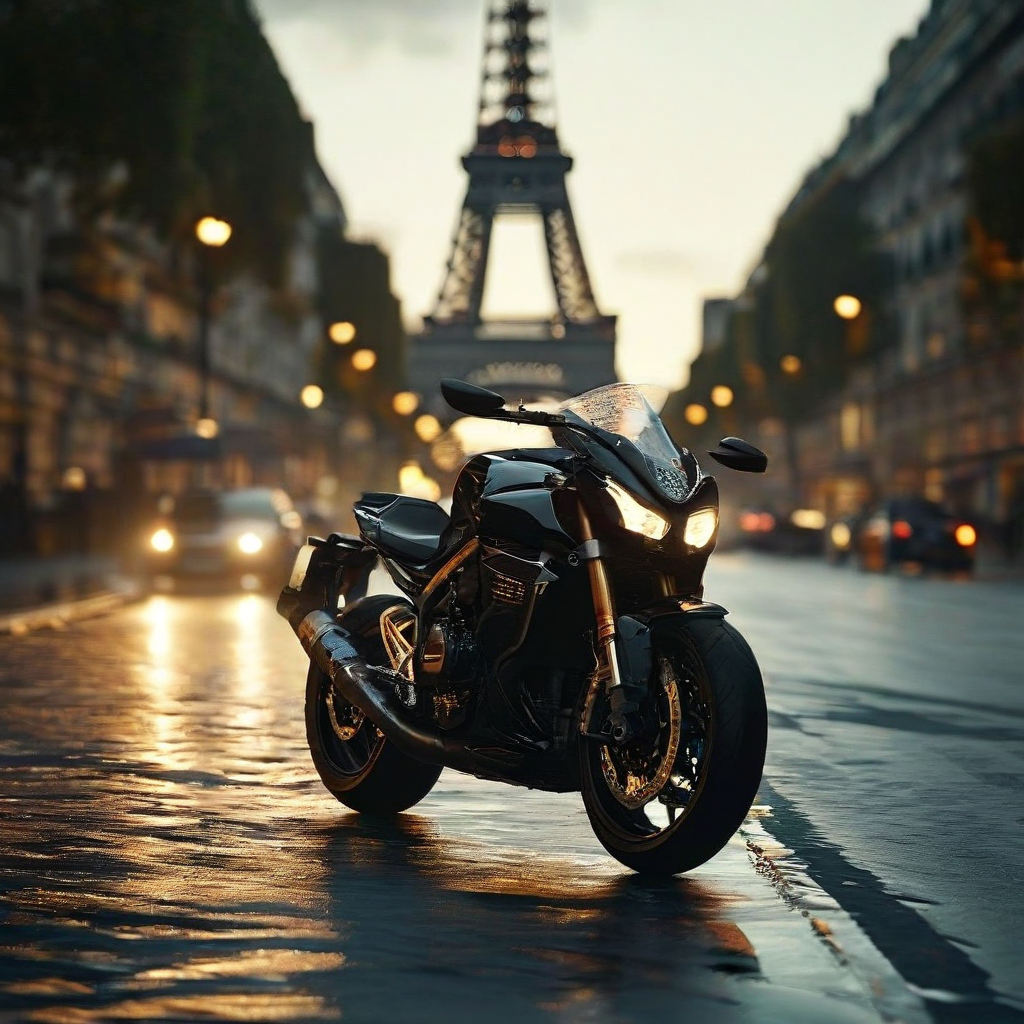
Avaliação Quantitativa
Para avaliar o Marigold quantitativamente em rankings e benchmarks padrão (como NYU, KITTI e outros conjuntos de dados),
siga o protocolo de avaliação descrito no artigo: carregue o modelo de precisão completa fp32 e use valores apropriados
para num_inference_steps e ensemble_size.
Opcionalmente, defina a semente de aleatoriedade para garantir reprodutibilidade.
Maximizar batch_size resultará no máximo uso do dispositivo.
import diffusers
import torch

device = "cuda"  # or "mps", "xpu", "cpu"
seed = 2024

generator = torch.Generator(device=device).manual_seed(seed)
pipe = diffusers.MarigoldDepthPipeline.from_pretrained("prs-eth/marigold-depth-v1-1").to(device)

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
    image,
    num_inference_steps=4,  # set according to the evaluation protocol from the paper
    ensemble_size=10,       # set according to the evaluation protocol from the paper
    generator=generator,
)

# evaluate metrics
Usando Incerteza Preditiva
O mecanismo de ensembling incorporado aos pipelines do Marigold combina múltiplas previsões obtidas a partir de diferentes latentes aleatórios.
Como efeito colateral, ele pode ser usado para quantificar a incerteza epistêmica (do modelo); basta especificar ensemble_size maior ou igual a 3 e definir output_uncertainty=True.
A incerteza resultante estará disponível no campo uncertainty da saída.
Ela pode ser visualizada da seguinte forma:
import diffusers
import torch

pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
    "prs-eth/marigold-depth-v1-1", variant="fp16", dtype=torch.float16
).to("cuda")  # or "mps", "xpu", "cpu"

image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")

depth = pipe(
	image,
	ensemble_size=10,  # any number >= 3
	output_uncertainty=True,
)

uncertainty = pipe.image_processor.visualize_uncertainty(depth.uncertainty)
uncertainty[0].save("einstein_depth_uncertainty.png")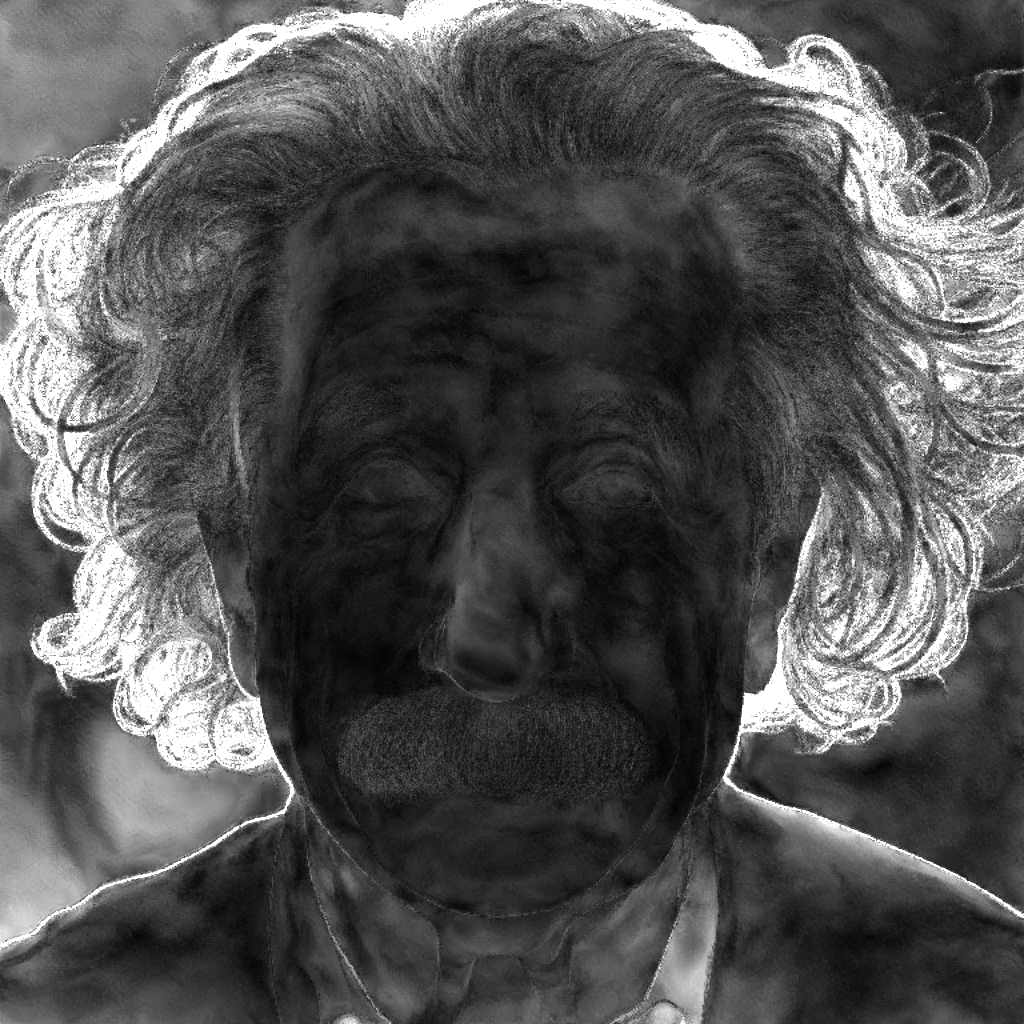
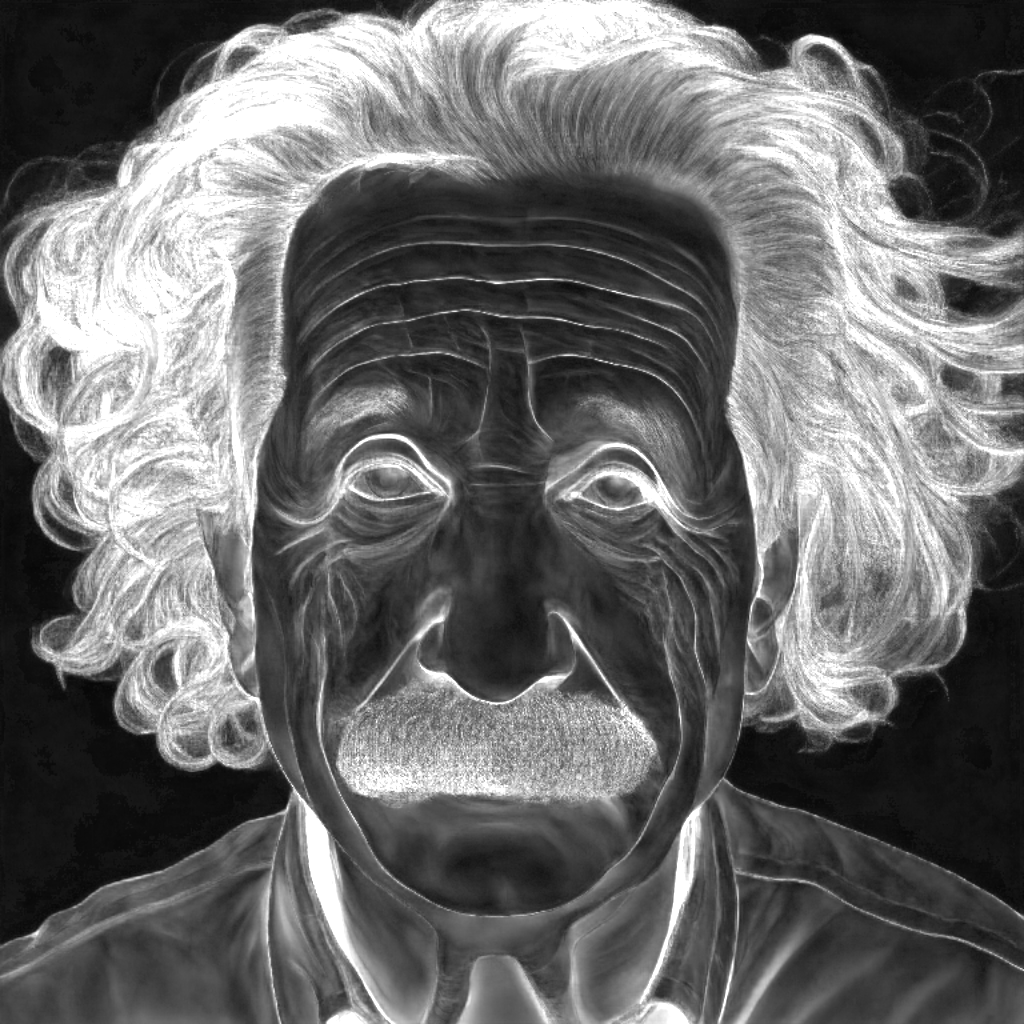

A interpretação da incerteza é simples: valores mais altos (branco) correspondem a pixels em que o modelo tem dificuldade em fazer previsões consistentes.
- O modelo de profundidade apresenta a maior incerteza em torno de descontinuidades, onde a profundidade do objeto muda abruptamente.
- O modelo de normais de superfície apresenta menor confiança em estruturas de granulação fina, como os fios de cabelo, e em regiões escuras, como a área da gola.
- A incerteza do albedo é representada como uma imagem RGB, pois captura a incerteza de forma independente para cada canal de cor, diferentemente da profundidade e das normais de superfície. Ela também é maior em regiões sombreadas e em descontinuidades.
API de Predição de Profundidade Marigold
classe diffusers.MarigoldDepthPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonescale_invariant: bool | None = Trueshift_invariant: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parâmetros
- unet (
UNet2DConditionModel) — U-Net condicional para desruidar o latente de profundidade, condicionado ao latente de imagem. - vae (
AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens e previsões para e a partir de representações latentes. - scheduler (
DDIMSchedulerouLCMScheduler) — Um scheduler a ser usado em combinação comunetpara desruidar os latentes da imagem codificada. - text_encoder (
CLIPTextModel) — Codificador de texto, para incorporação de texto vazio. - tokenizer (
CLIPTokenizer) — Tokenizador do CLIP. - prediction_type (
str, opcional) — Tipo de previsões feitas pelo modelo. - scale_invariant (
bool, opcional) — Uma propriedade do modelo que especifica se os mapas de profundidade previstos são invariantes em relação à escala. Este valor deve ser definido na configuração do modelo. Quando usado em conjunto com a flagshift_invariant=True, o modelo também é chamado de “invariante afim”. Obs.: a substituição deste valor não é suportada. - shift_invariant (
bool, opcional) — Uma propriedade do modelo que especifica se os mapas de profundidade previstos são invariantes a deslocamento. Este valor deve ser definido na configuração do modelo. Quando usado em conjunto com a flagscale_invariant=True, o modelo também é chamado de “invariante a afinidade”. Obs.: a substituição deste valor não é suportada. - default_denoising_steps (
int, opcional) — O número mínimo de etapas de difusão de desruido necessárias para produzir uma previsão de qualidade razoável com o modelo dado. Esse valor deve ser definido na configuração do modelo. Quando o pipeline é chamado sem definir explicitamentenum_inference_steps, o valor padrão é utilizado. Isso é necessário para garantir resultados razoáveis com as diversas variações de modelos compatíveis com o pipeline, como aquelas que dependem de agendamentos de desruido muito curtos (LCMScheduler) e aquelas com agendamentos de difusão completos (DDIMScheduler). - default_processing_resolution (
int, opcional) — O valor recomendado do parâmetroprocessing_resolutiondo pipeline. Esse valor deve ser definido na configuração do modelo. Quando o pipeline é chamado sem definir explicitamenteprocessing_resolution, o valor padrão é utilizado. Isso é necessário para garantir resultados razoáveis com as diversas variações de modelos treinadas com valores ótimos de resolução de processamento variados.
Pipeline para estimativa de profundidade monocular usando o método Marigold: https://marigoldmonodepth.github.io.
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldDepthOutput or tuple
Parâmetros
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray],list[torch.Tensor]): uma imagem de entrada ou imagens usadas como entrada para a tarefa de estimativa de profundidade. Para arrays e tensors, o intervalo de valores esperado é entre[0, 1]. É possível passar um lote de imagens fornecendo um array ou tensor de quatro dimensões. Além disso, é possível passar uma lista de imagens de arrays ou tensors de duas ou três dimensões. Nesse último caso, todos os elementos da lista devem ter a mesma largura e altura. - num_inference_steps (
int, opcional, padrãoNone) — Número de etapas de difusão de desruido durante a inferência. O valor padrãoNoneresulta em seleção automática. - ensemble_size (
int, padrão1) — Número de previsões de ensemble. Valores mais altos resultam em melhorias mensuráveis e degradação visual. - processing_resolution (
int, opcional, padrãoNone) — Resolução de processamento efetiva. Quando definido como0, corresponde à dimensão maior da imagem de entrada. Isso produz previsões mais nítidas, mas também pode levar à perda do contexto global. O valor padrãoNoneresolve para o valor ótimo da configuração do modelo. - match_input_resolution (
bool, opcional, padrãoTrue) — Quando habilitado, a previsão de saída é redimensionada para corresponder às dimensões de entrada. Quando desabilitado, o lado mais longo da saída será igual aprocessing_resolution. - resample_method_input (
str, opcional, padrão"bilinear") — Método de reamostragem usado para redimensionar as imagens de entrada paraprocessing_resolution. Os valores aceitos são:"nearest","nearest-exact","bilinear","bicubic"ou"area". - resample_method_output (
str, opcional, padrão"bilinear") — Método de reamostragem usado para redimensionar as previsões de saída para corresponder à resolução de entrada. Os valores aceitos são"nearest","nearest-exact","bilinear","bicubic"ou"area". - batch_size (
int, opcional, padrão1) — Tamanho do lote; só é relevante ao definirensemble_sizeou ao passar um tensor de imagens. - ensembling_kwargs (
dict, opcional, padrão éNone) — Dicionário extra com argumentos para controle preciso do ensembling. As seguintes opções estão disponíveis:- reduction (
str, opcional, padrão"median"): Define a função de ensembling aplicada em cada localização de pixel, podendo ser"median"ou"mean". - regularizer_strength (
float, opcional, padrão0.02): Força do regularizador que puxa as previsões alinhadas para o intervalo unitário de 0 a 1. - max_iter (
int, opcional, padrão2): Número máximo de etapas do solucionador de alinhamento. Consulte a funçãoscipy.optimize.minimize, argumentooptions. - tol (
float, opcional, padrão1e-3): Tolerância do solver de alinhamento. O solver para quando a tolerância é atingida. - max_res (
int, opcional, padrãoNone): Resolução na qual o alinhamento é realizado;Nonecorresponde aoprocessing_resolution.
- reduction (
- latents (
torch.Tensor, oulist[torch.Tensor], opcional, padrãoNone) — Tensores de ruído latente para substituir a inicialização aleatória. Eles podem ser obtidos da saída da chamada de função anterior. - generator (
torch.Generator, oulist[torch.Generator], opcional, padrãoNone) — Objeto gerador de números aleatórios para garantir reprodutibilidade. - output_type (
str, opcional, padrão"np") — Formato preferido dos campospredictioneuncertainty(opcional) da saída. Os valores aceitos são:"np"(array numpy) ou"pt"(tensor torch). - output_uncertainty (
bool, opcional, padrãoFalse) — Quando habilitado, o campouncertaintyda saída contém o mapa de incerteza preditiva, desde que o argumentoensemble_sizeesteja definido com um valor acima de 2. - output_latent (
bool, opcional, padrãoFalse) — Quando habilitado, o campolatentda saída contém os códigos latentes correspondentes às previsões dentro do ensemble. Esses códigos podem ser salvos, modificados e usados em chamadas subsequentes com o argumentolatents. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um MarigoldDepthOutput em vez de uma tupla simples.
Retorna
MarigoldDepthOutput ou tuple
Se return_dict for True, MarigoldDepthOutput é retornado; caso contrário, uma
tuple é retornada, em que o primeiro elemento é a previsão, o segundo é a incerteza
(ou None) e o terceiro é o latente (ou None).
Função invocada ao chamar o pipeline.
Exemplos:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldDepthPipeline.from_pretrained(
...     "prs-eth/marigold-depth-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> depth = pipe(image)

>>> vis = pipe.image_processor.visualize_depth(depth.prediction)
>>> vis[0].save("einstein_depth.png")

>>> depth_16bit = pipe.image_processor.export_depth_to_16bit_png(depth.prediction)
>>> depth_16bit[0].save("einstein_depth_16bit.png")
classe diffusers.pipelines.marigold.MarigoldDepthOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parâmetros
- prediction (
np.ndarray,torch.Tensor) — Mapas de profundidade previstos com valores no intervalo [0, 1]. A forma énumimages × 1 × height × widthparatorch.Tensorounumimages × height × width × 1paranp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Mapas de incerteza calculados a partir do ensemble, com valores no intervalo [0, 1]. A forma énumimages × 1 × height × widthparatorch.Tensorounumimages × height × width × 1paranp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape isnumimages * numensemble × 4 × latentheight × latentwidth.
Classe de saída para o pipeline de predição de profundidade monocular do Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_depth
< source >( depth: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]val_min: float = 0.0val_max: float = 1.0color_map: str = 'Spectral' )
Parâmetros
- depth (
PIL.Image.Image | np.ndarray | torch.Tensor | list[PIL.Image.Image, list[np.ndarray], -- list[torch.Tensor]]): Mapas de profundidade. - val_min (
float, opcional, padrão0.0) — Valor mínimo da faixa de profundura visualizada. - val_max (
float, opcional, padrão1.0) — Valor máximo da faixa de profundura visualizada. - color_map (
str, opcional, padrão"Spectral") — Mapa de cores usado para converter uma previsão de profundidade de canal único em uma representação colorida.
Visualiza mapas de profundidade, como as previsões do MarigoldDepthPipeline.
Retorna: list[PIL.Image.Image] com a visualização dos mapas de profundidade.
API de Estimação de Normais do Marigold
classe diffusers.MarigoldNormalsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Noneuse_full_z_range: bool | None = Truedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parâmetros
- unet (
UNet2DConditionModel) — U-Net condicional para desruidar o latente de normais, condicionado ao latente de imagem. - vae (
AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens e previsões para e a partir de representações latentes. - scheduler (
DDIMSchedulerouLCMScheduler) — Um scheduler a ser usado em combinação comunetpara desruidar os latentes da imagem codificada. - text_encoder (
CLIPTextModel) — Codificador de texto, para incorporação de texto vazio. - tokenizer (
CLIPTokenizer) — Tokenizador do CLIP. - prediction_type (
str, opcional) — Tipo de previsões feitas pelo modelo. - use_full_z_range (
bool, opcional) — Se as normais previstas por este modelo utilizam o intervalo completo da dimensão Z ou apenas sua metade positiva. - default_denoising_steps (
int, opcional) — O número mínimo de etapas de difusão de desruido necessárias para produzir uma previsão de qualidade razoável com o modelo dado. Esse valor deve ser definido na configuração do modelo. Quando o pipeline é chamado sem definir explicitamentenum_inference_steps, o valor padrão é utilizado. Isso é necessário para garantir resultados razoáveis com as diversas variações de modelos compatíveis com o pipeline, como aquelas que dependem de agendamentos de desruido muito curtos (LCMScheduler) e aquelas com agendamentos de difusão completos (DDIMScheduler). - default_processing_resolution (
int, opcional) — O valor recomendado do parâmetroprocessing_resolutiondo pipeline. Esse valor deve ser definido na configuração do modelo. Quando o pipeline é chamado sem definir explicitamenteprocessing_resolution, o valor padrão é utilizado. Isso é necessário para garantir resultados razoáveis com as diversas variações de modelos treinadas com valores ótimos de resolução de processamento variados.
Pipeline para estimativa de normais monoculares usando o método Marigold: https://marigoldmonodepth.github.io.
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldNormalsOutput or tuple
Parâmetros
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray],list[torch.Tensor]): uma imagem de entrada ou imagens usadas como entrada para a tarefa de estimativa de normais. Para arrays e tensors, o intervalo de valores esperado é entre[0, 1]. É possível passar um lote de imagens fornecendo um array ou tensor de quatro dimensões. Além disso, é possível passar uma lista de imagens de arrays ou tensors de duas ou três dimensões. Nesse último caso, todos os elementos da lista devem ter a mesma largura e altura. - num_inference_steps (
int, opcional, padrãoNone) — Número de etapas de difusão de desruido durante a inferência. O valor padrãoNoneresulta em seleção automática. - ensemble_size (
int, padrão1) — Número de previsões de ensemble. Valores mais altos resultam em melhorias mensuráveis e degradação visual. - processing_resolution (
int, opcional, padrãoNone) — Resolução de processamento efetiva. Quando definido como0, corresponde à dimensão maior da imagem de entrada. Isso produz previsões mais nítidas, mas também pode levar à perda do contexto global. O valor padrãoNoneresolve para o valor ótimo da configuração do modelo. - match_input_resolution (
bool, opcional, padrãoTrue) — Quando habilitado, a previsão de saída é redimensionada para corresponder às dimensões de entrada. Quando desabilitado, o lado mais longo da saída será igual aprocessing_resolution. - resample_method_input (
str, opcional, padrão"bilinear") — Método de reamostragem usado para redimensionar as imagens de entrada paraprocessing_resolution. Os valores aceitos são:"nearest","nearest-exact","bilinear","bicubic"ou"area". - resample_method_output (
str, opcional, padrão"bilinear") — Método de reamostragem usado para redimensionar as previsões de saída para corresponder à resolução de entrada. Os valores aceitos são"nearest","nearest-exact","bilinear","bicubic"ou"area". - batch_size (
int, opcional, padrão1) — Tamanho do lote; só é relevante ao definirensemble_sizeou ao passar um tensor de imagens. - ensembling_kwargs (
dict, opcional, padrão éNone) — Dicionário extra com argumentos para controle preciso do ensembling. As seguintes opções estão disponíveis:- reduction (
str, opcional, padrão"closest"): Define a função de ensembling aplicada em cada localização de pixel, podendo ser"closest"ou"mean".
- reduction (
- latents (
torch.Tensor, opcional, padrãoNone) — Tensores de ruído latente para substituir a inicialização aleatória. Eles podem ser obtidos da saída da chamada de função anterior. - generator (
torch.Generator, oulist[torch.Generator], opcional, padrãoNone) — Objeto gerador de números aleatórios para garantir reprodutibilidade. - output_type (
str, opcional, padrão"np") — Formato preferido dos campospredictioneuncertainty(opcional) da saída. Os valores aceitos são:"np"(array numpy) ou"pt"(tensor torch). - output_uncertainty (
bool, opcional, padrãoFalse) — Quando habilitado, o campouncertaintyda saída contém o mapa de incerteza preditiva, desde que o argumentoensemble_sizeesteja definido com um valor acima de 2. - output_latent (
bool, opcional, padrãoFalse) — Quando habilitado, o campolatentda saída contém os códigos latentes correspondentes às previsões dentro do ensemble. Esses códigos podem ser salvos, modificados e usados em chamadas subsequentes com o argumentolatents. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um MarigoldNormalsOutput em vez de uma tupla simples.
Retorna
MarigoldNormalsOutput ou tuple
Se return_dict for True, MarigoldNormalsOutput é retornado; caso contrário, uma
tuple é retornada, em que o primeiro elemento é a previsão, o segundo é a incerteza
(ou None) e o terceiro é o latente (ou None).
Função invocada ao chamar o pipeline.
Exemplos:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldNormalsPipeline.from_pretrained(
...     "prs-eth/marigold-normals-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> normals = pipe(image)

>>> vis = pipe.image_processor.visualize_normals(normals.prediction)
>>> vis[0].save("einstein_normals.png")
classe diffusers.pipelines.marigold.MarigoldNormalsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parâmetros
- prediction (
np.ndarray,torch.Tensor) — Normais previstas com valores no intervalo [-1, 1]. A forma énumimages × 3 × height × widthparatorch.Tensorounumimages × height × width × 3paranp.ndarray. - uncertainty (
None,np.ndarray,torch.Tensor) — Mapas de incerteza calculados a partir do ensemble, com valores no intervalo [0, 1]. A forma énumimages × 1 × height × widthparatorch.Tensorounumimages × height × width × 1paranp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape isnumimages * numensemble × 4 × latentheight × latentwidth.
Classe de saída para o pipeline de predição de normais monoculares do Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_normals
< source >( normals: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]flip_x: bool = Falseflip_y: bool = Falseflip_z: bool = False )
Parâmetros
- normals (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Normais da superfície. - flip_x (
bool, opcional, padrãoFalse) — Inverte o eixo X do referencial dos normais. A direção padrão é para a direita. - flip_y (
bool, opcional, padrãoFalse) — Inverte o eixo Y do sistema de referência dos normais. A direção padrão é para cima. - flip_z (
bool, opcional, padrãoFalse) — Inverte o eixo Z do referencial dos normais. A direção padrão é voltada para o observador.
Visualiza normais de superfície, como as previsões do MarigoldNormalsPipeline.
Retorna: list[PIL.Image.Image] com a visualização dos normais da superfície.
API de Decomposição de Imagem Intrínseca do Marigold
classe diffusers.MarigoldIntrinsicsPipeline
< source >( unet: UNet2DConditionModelvae: AutoencoderKLscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_lcm.LCMSchedulertext_encoder: CLIPTextModeltokenizer: CLIPTokenizerprediction_type: str | None = Nonetarget_properties: dict[str, typing.Any] | None = Nonedefault_denoising_steps: int | None = Nonedefault_processing_resolution: int | None = None )
Parâmetros
- unet (
UNet2DConditionModel) — U-Net condicional para desruidar o latente dos alvos, condicionado ao latente da imagem. - vae (
AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar e decodificar imagens e previsões para e a partir de representações latentes. - scheduler (
DDIMSchedulerouLCMScheduler) — Um scheduler a ser usado em combinação comunetpara desruidar os latentes da imagem codificada. - text_encoder (
CLIPTextModel) — Codificador de texto, para incorporação de texto vazio. - tokenizer (
CLIPTokenizer) — Tokenizador do CLIP. - prediction_type (
str, opcional) — Tipo de previsões feitas pelo modelo. - target_properties (
dict[str, Any], opcional) — Propriedades das modalidades previstas, comotarget_names, umalist[str]usada para definir a quantidade, a ordem e os nomes das modalidades previstas, e quaisquer outros metadados que possam ser necessários para interpretar as previsões. - default_denoising_steps (
int, opcional) — O número mínimo de etapas de difusão de desruido necessárias para produzir uma previsão de qualidade razoável com o modelo dado. Esse valor deve ser definido na configuração do modelo. Quando o pipeline é chamado sem definir explicitamentenum_inference_steps, o valor padrão é utilizado. Isso é necessário para garantir resultados razoáveis com as diversas variações de modelos compatíveis com o pipeline, como aquelas que dependem de agendamentos de desruido muito curtos (LCMScheduler) e aquelas com agendamentos de difusão completos (DDIMScheduler). - default_processing_resolution (
int, opcional) — O valor recomendado do parâmetroprocessing_resolutiondo pipeline. Esse valor deve ser definido na configuração do modelo. Quando o pipeline é chamado sem definir explicitamenteprocessing_resolution, o valor padrão é utilizado. Isso é necessário para garantir resultados razoáveis com as diversas variações de modelos treinadas com valores ótimos de resolução de processamento variados.
Pipeline para Decomposição de Imagem Intrínseca (IID) usando o método Marigold: https://marigoldcomputervision.github.io.
Este modelo herda de DiffusionPipeline. Consulte a documentação da superclasse para os métodos genéricos que a biblioteca implementa para todos os pipelines (como download ou salvamento, execução em um dispositivo específico, etc.)
__call__
< source >( image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]num_inference_steps: int | None = Noneensemble_size: int = 1processing_resolution: int | None = Nonematch_input_resolution: bool = Trueresample_method_input: str = 'bilinear'resample_method_output: str = 'bilinear'batch_size: int = 1ensembling_kwargs: dict[str, typing.Any] | None = Nonelatents: typing.Union[torch.Tensor, list[torch.Tensor], NoneType] = Nonegenerator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str = 'np'output_uncertainty: bool = Falseoutput_latent: bool = Falsereturn_dict: bool = True ) → MarigoldIntrinsicsOutput or tuple
Parâmetros
- image (
PIL.Image.Image,np.ndarray,torch.Tensor,list[PIL.Image.Image],list[np.ndarray],list[torch.Tensor]): uma imagem de entrada ou imagens usadas como entrada para a tarefa de decomposição intrínseca. Para arrays e tensors, o intervalo de valores esperado é entre[0, 1]. É possível passar um lote de imagens fornecendo um array ou tensor de quatro dimensões. Além disso, é possível passar uma lista de imagens de arrays ou tensors de duas ou três dimensões. Nesse último caso, todos os elementos da lista devem ter a mesma largura e altura. - num_inference_steps (
int, opcional, padrãoNone) — Número de etapas de difusão de desruido durante a inferência. O valor padrãoNoneresulta em seleção automática. - ensemble_size (
int, padrão1) — Número de previsões de ensemble. Valores mais altos resultam em melhorias mensuráveis e degradação visual. - processing_resolution (
int, opcional, padrãoNone) — Resolução de processamento efetiva. Quando definido como0, corresponde à dimensão maior da imagem de entrada. Isso produz previsões mais nítidas, mas também pode levar à perda do contexto global. O valor padrãoNoneresolve para o valor ótimo da configuração do modelo. - match_input_resolution (
bool, opcional, padrãoTrue) — Quando habilitado, a previsão de saída é redimensionada para corresponder às dimensões de entrada. Quando desabilitado, o lado mais longo da saída será igual aprocessing_resolution. - resample_method_input (
str, opcional, padrão"bilinear") — Método de reamostragem usado para redimensionar as imagens de entrada paraprocessing_resolution. Os valores aceitos são:"nearest","nearest-exact","bilinear","bicubic"ou"area". - resample_method_output (
str, opcional, padrão"bilinear") — Método de reamostragem usado para redimensionar as previsões de saída para corresponder à resolução de entrada. Os valores aceitos são"nearest","nearest-exact","bilinear","bicubic"ou"area". - batch_size (
int, opcional, padrão1) — Tamanho do lote; só é relevante ao definirensemble_sizeou ao passar um tensor de imagens. - ensembling_kwargs (
dict, opcional, padrão éNone) — Dicionário extra com argumentos para controle preciso do ensembling. As seguintes opções estão disponíveis:- reduction (
str, opcional, padrão"median"): Define a função de ensembling aplicada em cada localização de pixel, podendo ser"median"ou"mean".
- reduction (
- latents (
torch.Tensor, opcional, padrãoNone) — Tensores de ruído latente para substituir a inicialização aleatória. Eles podem ser obtidos da saída da chamada de função anterior. - generator (
torch.Generator, oulist[torch.Generator], opcional, padrãoNone) — Objeto gerador de números aleatórios para garantir reprodutibilidade. - output_type (
str, opcional, padrão"np") — Formato preferido dos campospredictioneuncertainty(opcional) da saída. Os valores aceitos são:"np"(array numpy) ou"pt"(tensor torch). - output_uncertainty (
bool, opcional, padrãoFalse) — Quando habilitado, o campouncertaintyda saída contém o mapa de incerteza preditiva, desde que o argumentoensemble_sizeesteja definido com um valor acima de 2. - output_latent (
bool, opcional, padrãoFalse) — Quando habilitado, o campolatentda saída contém os códigos latentes correspondentes às previsões dentro do ensemble. Esses códigos podem ser salvos, modificados e usados em chamadas subsequentes com o argumentolatents. - return_dict (
bool, opcional, padrãoTrue) — Se deve ou não retornar um MarigoldIntrinsicsOutput em vez de uma tupla simples.
Retorna
MarigoldIntrinsicsOutput ou tuple
Se return_dict for True, MarigoldIntrinsicsOutput é retornado; caso contrário, uma
tuple é retornada, em que o primeiro elemento é a previsão, o segundo é a incerteza
(ou None) e o terceiro é o latente (ou None).
Função invocada ao chamar o pipeline.
Exemplos:
>>> import diffusers
>>> import torch

>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
...     "prs-eth/marigold-iid-appearance-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")

>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)

>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["roughness"].save("einstein_roughness.png")
>>> vis[0]["metallicity"].save("einstein_metallicity.png")>>> import diffusers
>>> import torch
>>> pipe = diffusers.MarigoldIntrinsicsPipeline.from_pretrained(
... "prs-eth/marigold-iid-lighting-v1-1", variant="fp16", torch_dtype=torch.float16
... ).to("cuda")
>>> image = diffusers.utils.load_image("https://marigoldmonodepth.github.io/images/einstein.jpg")
>>> intrinsics = pipe(image)
>>> vis = pipe.image_processor.visualize_intrinsics(intrinsics.prediction, pipe.target_properties)
>>> vis[0]["albedo"].save("einstein_albedo.png")
>>> vis[0]["shading"].save("einstein_shading.png")
>>> vis[0]["residual"].save("einstein_residual.png")classe diffusers.pipelines.marigold.MarigoldIntrinsicsOutput
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor]uncertainty: typing.Union[NoneType, numpy.ndarray, torch.Tensor]latent: typing.Optional[torch.Tensor] )
Parâmetros
- prediction (
np.ndarray,torch.Tensor) — Intrínsecos da imagem previstos com valores no intervalo [0, 1]. A forma é(numimages * numtargets) × 3 × height × widthparatorch.Tensorou(numimages * numtargets) × height × width × 3paranp.ndarray, ondenumtargetscorresponde ao número de modalidades de destino previstas da decomposição da imagem intrínseca. - uncertainty (
None,np.ndarray,torch.Tensor) — Mapas de incerteza calculados a partir do ensemble, com valores no intervalo [0, 1]. A forma é(numimages * numtargets) × 3 × height × widthparatorch.Tensorou(numimages * numtargets) × height × width × 3paranp.ndarray. - latent (
None,torch.Tensor) — Latent features corresponding to the predictions, compatible with thelatentsargument of the pipeline. The shape is(numimages * numensemble) × (numtargets * 4) × latentheight × latentwidth.
Classe de saída para o pipeline de Decomposição de Imagem Intrínseca do Marigold.
diffusers.pipelines.marigold.MarigoldImageProcessor.visualize_intrinsics
< source >( prediction: typing.Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]]target_properties: dict[str, typing.Any]color_map: str | dict[str, str] = 'binary' )
Parâmetros
- prediction (
np.ndarray | torch.Tensor | list[np.ndarray, list[torch.Tensor]]) — Decomposição de imagem intrínseca. - target_properties (
dict[str, Any]) — Propriedades de decomposição. Entradas esperadas:target_names: list[str]e um dicionário com as chavesprediction_space: str,sub_target_names: list[str | Null](deve ter 3 entradas, null para modalidades ausentes),up_to_scale: bool, uma para cada alvo e subalvo. - color_map (
str | dict[str, str], opcional, padrão"Spectral") — Mapa de cores usado para converter previsões de um único canal em representações coloridas. Quando um dicionário é passado, cada modalidade pode ser colorida com seu próprio mapa de cores.
Visualiza a decomposição de imagem intrínseca, como as previsões do MarigoldIntrinsicsPipeline.
Retorna: list[dict[str, PIL.Image.Image]] com a visualização da decomposição de imagem intrínseca.