
Hub documentation
アップロードするデータセット
アップロードするデータセット
Hubには、コミュニティが厳選したデータセットや研究用データセットの広範なコレクションが収められています。MLコミュニティの成長と、すべての人のための進歩の加速に貢献するため、データセットをHubに共有することをお勧めします。すべての貢献を歓迎しています。データセットの追加は、ドラッグ&ドロップだけで簡単にできます!
アカウントをお持ちでない場合は、まずHugging Face Hubのアカウントを作成してください。
Hub UIを使用してアップロードする
HubのWebベースのインターフェースにより、開発経験のないユーザーでもデータセットをアップロードできます。
リポジトリを作成する
リポジトリは、リビジョン履歴を含むすべてのデータセットファイルをホストするため、複数のデータセットバージョンを保存することが可能になります。
- プロファイルをクリックし、New Datasetを選択して、新しいデータセットリポジトリを作成します。
- データセットの名前を決定し、公開データセットにするか非公開データセットにするかを選択します。公開データセットは誰でも閲覧できますが、非公開データセットはあなた自身またはあなたの組織のメンバーのみが閲覧できます。

データセットをアップロード
- リポジトリを作成したら、Files and versionsタブに移動してファイルを追加します。Add fileを選択して、データセットのファイルをアップロードします。
.csv、.mp3、.jpgなど、テキスト、音声、画像、その他の多くのデータ拡張子に対応しています(File formatsの完全なリストを参照してください)。
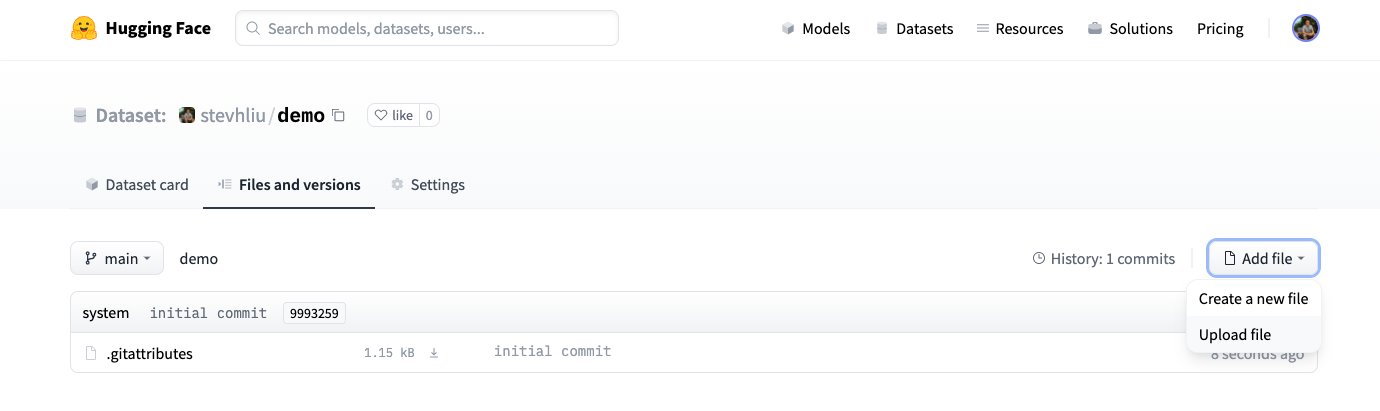
- データセットファイルをドラッグ&ドロップしてください。

- データセットファイルをアップロードすると、データセットリポジトリに保存されます。

Datasetカードを作成する
Dataset cardを追加することは、ユーザーがあなたのデータセットを見つけやすくし、責任ある使用方法を理解してもらうために非常に価値があります。
- Dataset Card を作成をクリックして、Dataset cardを作成します。このボタンはリポジトリに
README.mdファイルを作成します。

上部には、ライセンス、言語、タスクカテゴリなどを選択できる複数のフィールドを持つMetadata UIが表示されます。これらは、Hub上でユーザーがあなたのデータセットを見つけやすくするための最も重要なタグです(該当する場合)。フィールドのオプションを選択すると、自動的にデータセットカードの上部に追加されます。
Dataset Card の仕様も参照できます。この仕様には、
annotations_creatorsなどの任意のタグを含む、許可されているタグの完全なセットが記載されており、データセットに有用なタグを選択する際に役立ちます。
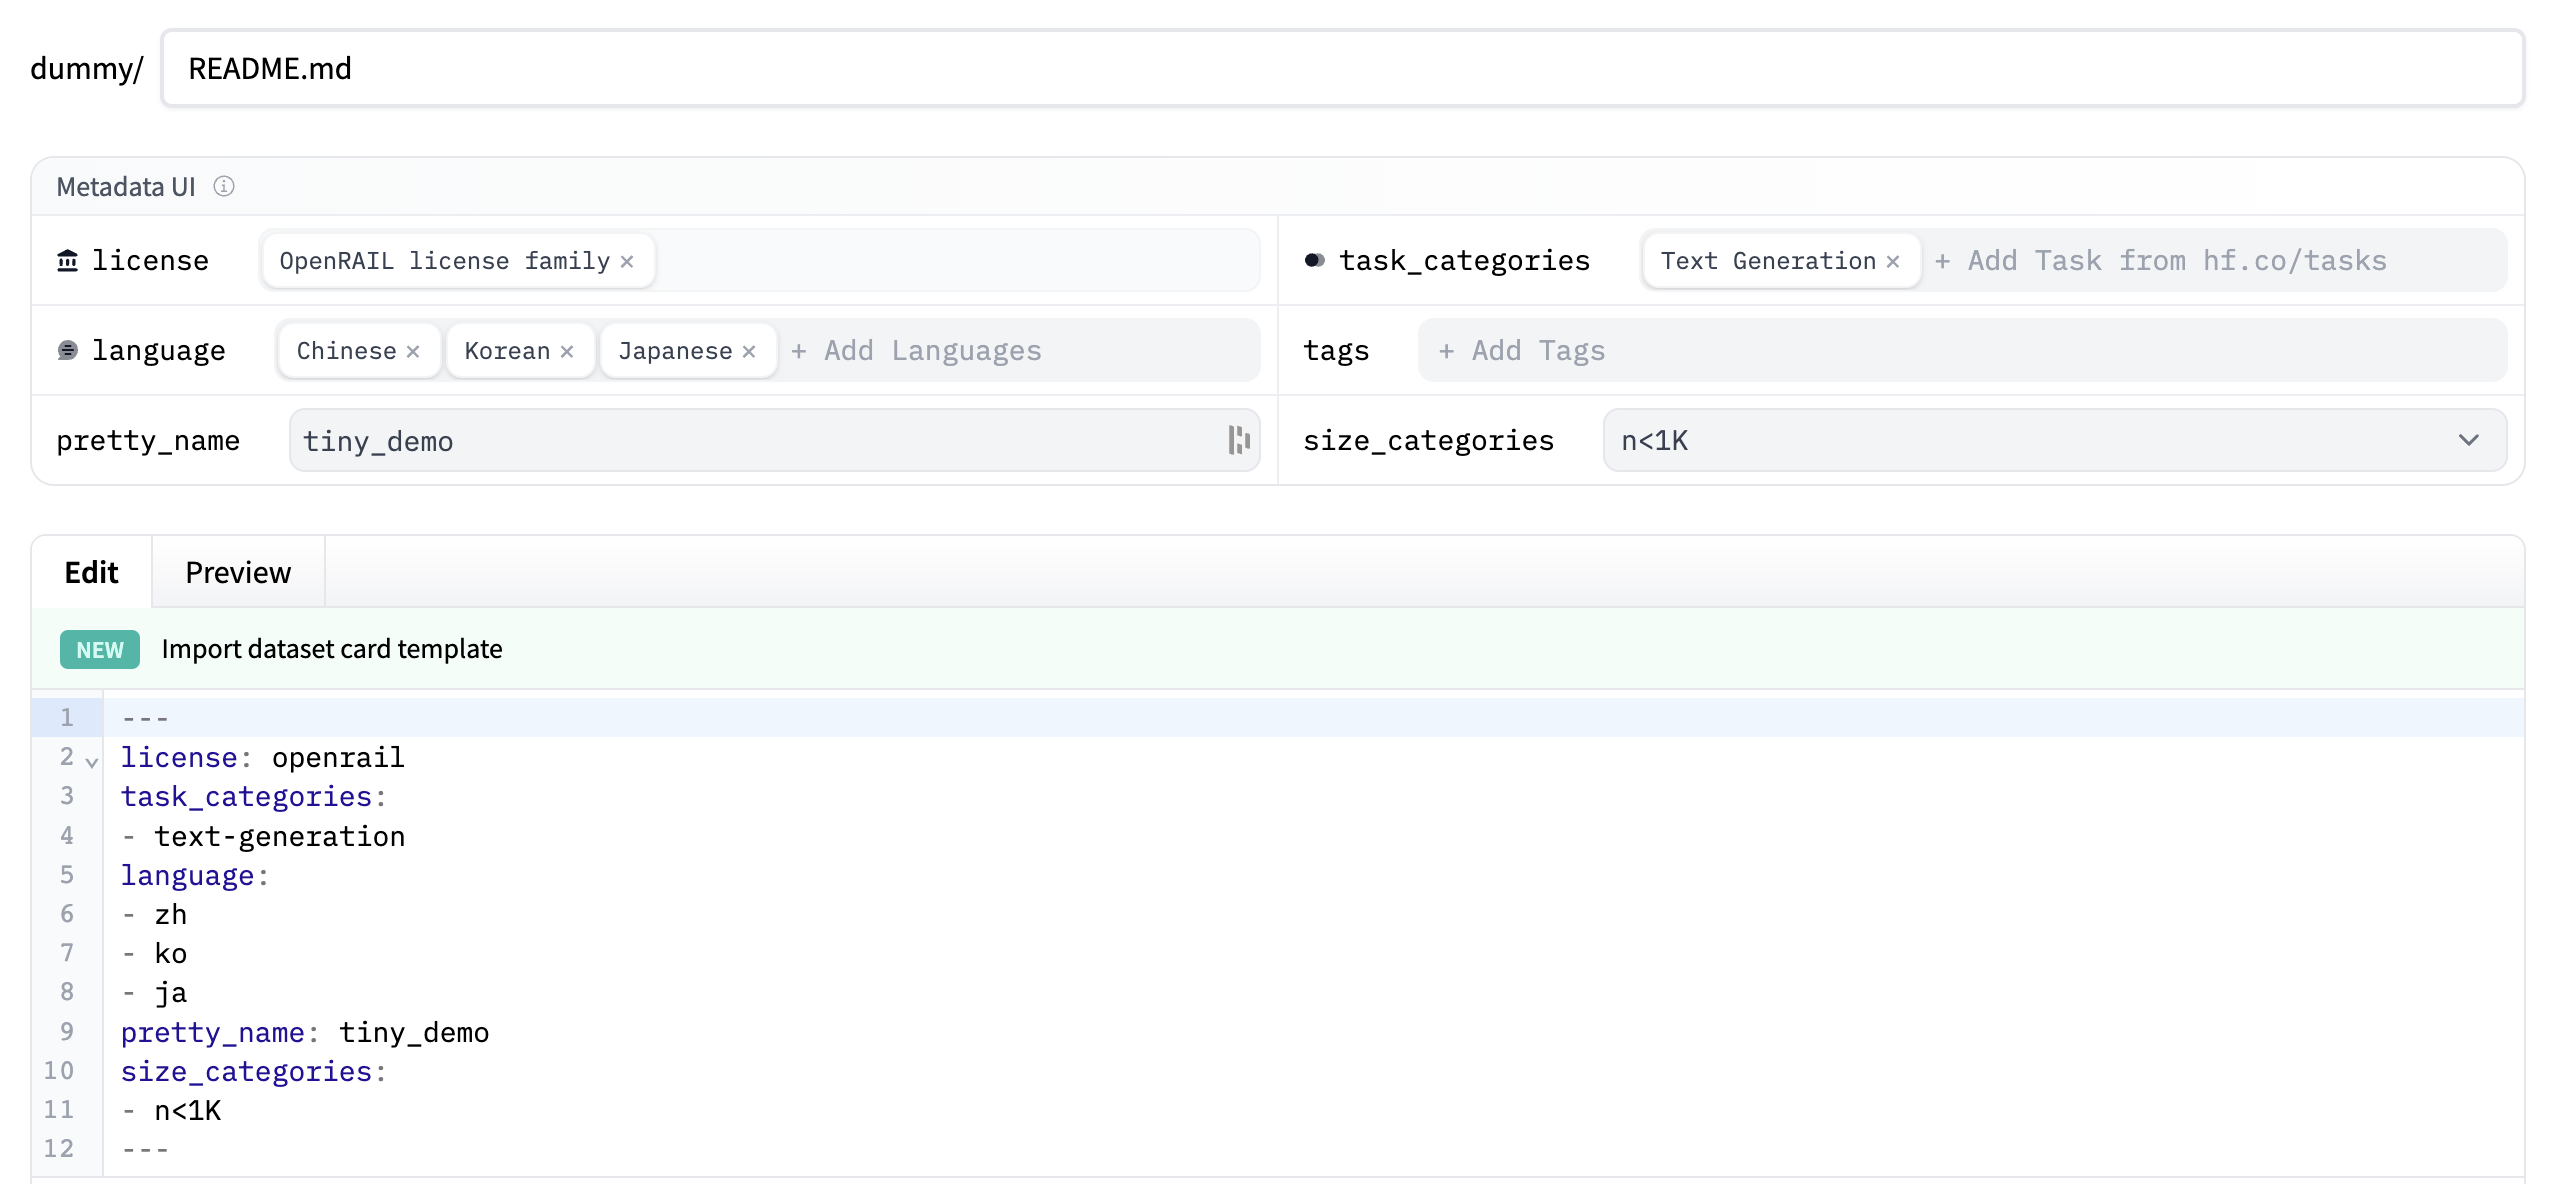
Dataset Card にデータセットのドキュメントを作成し、コミュニティにデータセットを紹介してください。これにより、ユーザーはデータセットの内容、具体的にはユースケースと制約事項、データのソース、重要な倫理的考慮事項、その他の関連する詳細を理解しやすくなります。
エディタの上部にあるImport dataset card templateリンクをクリックすると、データセットカードのテンプレートが自動的に作成されます。優れたDataset cardの具体的な例については、CNN DailyMail Dataset cardをご覧ください。
huggingface_hubクライアントライブラリを使用する
huggingface_hub ライブラリには豊富な機能が備わっており、リポジトリの管理、リポジトリの作成、Hub へのデータセットのアップロードなどが可能です。詳細については、クライアントライブラリのドキュメントをご覧ください。
他のライブラリを使用する
🤗 Datasets、Pandas、Polars、Dask、DuckDB、Daft などのライブラリは、ファイルを Hub にアップロードできます。 詳細については、Datasets Hub でサポートされているライブラリの一覧を参照してください。
Gitの使用
データセットのリポジトリは Git リポジトリであるため、Git を使用して Hub にデータファイルをプッシュできます。リポジトリの入門のガイドに従い、git CLI を使用してデータセットをコミットおよびプッシュする方法を学習してください。
データセットの取り込み
データベース、クラウドストレージ、またはAPIの背後にあるデータがある場合、それらをHugging Faceにインポートし、すぐに使用できるデータセットとして利用できます。
データセットの取り込みに関するドキュメントで詳細を確認してください。
ファイル形式
Hubは複数のファイル形式をネイティブでサポートしています:
- Parquet (.parquet)
- CSV (.csv, .tsv)
- JSON Lines、JSON(.jsonl、.json)
- ArrowストリーミングおよびIPC形式(.arrow)
- テキスト (.txt)
- 画像(.png、.jpg など)
- オーディオ(.wav、.mp3 など)
- 動画(.mp4、.mov、.avi など)
- PDF (.pdf)
- WebDataset(.tar)
- Lance(.lance)
ZIP (.zip)、GZIP (.gz)、ZSTD (.zst)、BZ2 (.bz2)、LZ4 (.lz4)、LZMA (.xz) 形式で圧縮されたファイルに対応しています。
画像ファイルや音声ファイルには、追加のメタデータファイルを持つ場合があります。画像および音声データセットのデータファイルの構成、およびCSV、TSV、画像のサンプルデータセットのコレクションを参照してください。
Hubのすべての機能を活用するために、ファイルをこれらの形式に変換することをお勧めします。 その他の形式や構造は、Hubによって認識されない場合があります。
どのファイル形式を使用すべきですか?
ほとんどのタイプのデータセットでは、Parquet形式が推奨されます。これは、効率的な圧縮、豊富な型情報、そして最適化された読み取りやバッチ操作に対応する多様なツールがこの形式をサポートしているためです。代替案として、表形式のデータには CSV または JSON Lines/JSON を使用できます(ネストされたデータには JSON Lines が推奨されます)。Parquet と比較して解析は容易ですが、これらの形式は数 GB を超えるデータには推奨されません。画像や音声のデータセットについては、個々のファイルへのアクセスが容易であるため、ほとんどのユースケースでは生のファイルをアップロードするのが最も実用的です。大規模な画像や音声データセットのストリーミング処理では、個々のファイルへのアクセスに伴うオーバーヘッドを避けるため、生の画像や音声ファイルよりも WebDataset を優先すべきです。ただし、分析、データフィルタリング、メタデータのパースなどを含むより一般的なユースケースでは、大規模な画像や音声データセットには Parquet が推奨される選択肢です。
Data Studio
Data Studioは、ダウンロード前にデータの実際の様子を把握するのに役立ちます。 すべての公開データセットでデフォルトで有効になっています。PROユーザーまたはTeam or Enterprise organizationが所有する非公開データセットでも利用できます。
データセットをアップロードした後、Dataset Viewer がデータを正しく表示していることを確認するか、Dataset Viewer を設定してください。
大規模データセット
Hugging Face Hubは、大規模なデータセットをサポートしています。通常、データセットはpush_to_hub()(🤗 Datasetsを使用)でParquet形式、またはWebDataset形式でアップロードされます。
huggingface_hub ライブラリの upload_folder() または hf upload を使用して、大きなフォルダをアップロードできます。これらはアップロードを複数のコミットに分割し、中断された場合は自動的に再開します。
大規模なフォルダのアップロード方法、大規模なアップロードのヒントとコツ、リポジトリのストレージ制限と推奨事項を参照してください。
Update on GitHub