
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT) est une méthode générique conçue pour l’ajustement fin des modèles de fondation. Elle améliore l’efficacité paramétrique du paradigme d’ajustement fin — Orthogonal Finetuning (OFT) — en s’inspirant de la transformée de Fourier rapide de Cooley-Tukey, et obtient des résultats favorables lors de l’ajustement fin de différents modèles de fondation, y compris de grands vision transformers, de grands modèles de langage et des modèles de diffusion texte-vers-image.
L'abstract de l'article est :
Les grands modèles de fondation sont devenus omniprésents, mais les entraîner à partir de zéro est prohibitivement coûteux. Ainsi, adapter efficacement ces modèles puissants à des tâches en aval est de plus en plus important. Dans cet article, nous étudions un paradigme d’ajustement fin (finetuning) fondé sur des principes — l’ajustement fin orthogonal (Orthogonal Finetuning, OFT) — pour l’adaptation à des tâches en aval. Malgré une bonne généralisabilité, OFT utilise encore un nombre relativement élevé de paramètres entraînables en raison de la haute dimensionnalité des matrices orthogonales. Pour y remédier, nous commençons par examiner OFT sous l’angle de la transmission d’information, puis nous identifions quelques exigences clés permettant une meilleure efficacité en paramètres. Inspirés par la façon dont l’algorithme de transformée de Fourier rapide de Cooley-Tukey permet une transmission d’information efficace, nous proposons une paramétrisation orthogonale efficace utilisant des structures en papillon (butterfly). Nous appliquons cette paramétrisation à OFT, créant ainsi une nouvelle méthode d’ajustement fin efficace en paramètres, appelée Orthogonal Butterfly (BOFT). En subsumant OFT comme cas particulier, BOFT introduit un cadre généralisé d’ajustement fin orthogonal. Enfin, nous menons une étude empirique approfondie de l’adaptation de grands transformeurs visuels, de grands modèles de langage et de modèles de diffusion texte-vers-image à diverses tâches en aval en vision et en langage.
BOFT se concentre sur la préservation des capacités génératives d'un modèle pré-entraîné tout en étant nettement plus efficace en termes de paramètres que le OFT standard. Comme OFT, BOFT maintient la même similarité cosinus (hyperspherical energy) entre toutes les paires de neurones d'une couche en appliquant une transformation orthogonale à la matrice de poids pré-entraînée, garantissant ainsi que les relations sémantiques entre les neurones sont préservées.
Plutôt que d’utiliser une matrice orthogonale bloc-diagonale, BOFT factorise la transformation orthogonale en un produit de matrices papillon creuses (introduites à l’origine dans la FFT de Cooley–Tukey). Contrairement aux rotations bloc-diagonales de OFT, qui ne mélangent les entrées qu’à l’intérieur de chaque bloc, la structure papillon garantit que chaque entrée peut influencer chaque sortie, produisant une connectivité dense avec seulement O(d log d) paramètres. Cette factorisation préserve l’expressivité tout en réduisant considérablement le nombre de paramètres par rapport à OFT (au prix du temps de calcul).
En pratique, BOFT multiplie chaque matrice de poids préentraînée par une suite de facteurs orthogonaux structurés en papillon, permettant des rotations de neurones efficaces et expressives. Cela rend BOFT particulièrement adapté à la génération contrôlée et aux tâches où le maintien de la représentation du sujet du modèle préentraîné est crucial, tout en permettant de passer à l'échelle vers des modèles plus volumineux avec une empreinte mémoire et un coût de calcul réduits.
BOFT peut être appliqué à n'importe quel sous-ensemble de matrices de poids d'un réseau de neurones afin de réduire le nombre de paramètres entraînables. Étant donné les couches cibles pour l'injection des paramètres BOFT, le nombre de paramètres entraînables peut être déterminé en fonction de la taille des matrices de poids.
Aperçu des benchmarks
Fusionner les poids BOFT dans le modèle de base
De manière similaire à LoRA, les poids appris par BOFT peuvent être intégrés aux matrices de poids préentraînées à l'aide de la fonction [~BOFTModel.merge_and_unload(). Cette fonction fusionne les poids de l'adaptateur avec le modèle de base, ce qui vous permet d'utiliser efficacement le modèle nouvellement fusionné comme un modèle autonome.
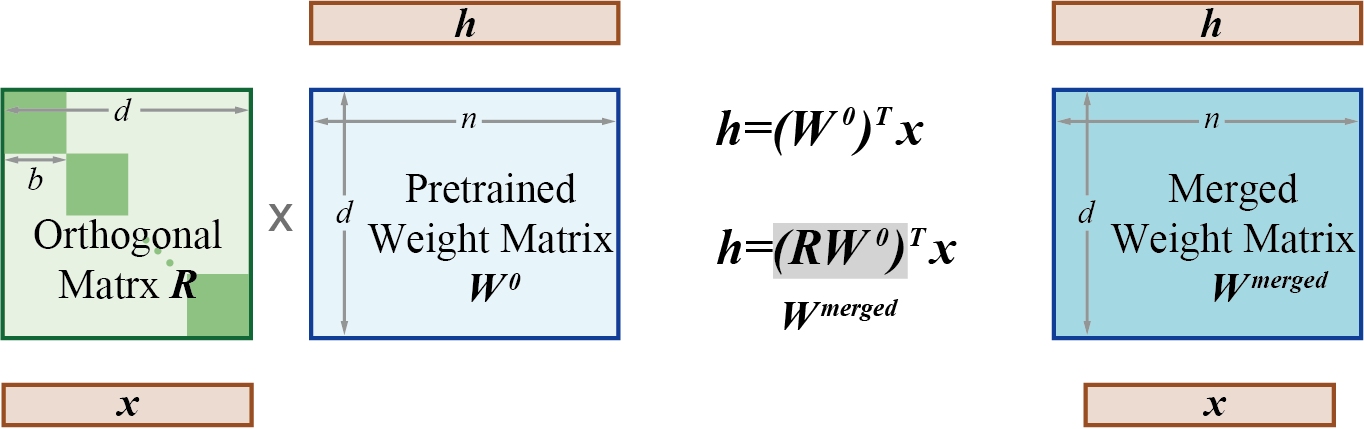
Cela fonctionne car, pendant l’entraînement, la matrice de poids orthogonale (R dans le schéma ci-dessus) et les matrices de poids pré-entraînées sont distinctes. Mais une fois l’entraînement terminé, ces poids peuvent en réalité être fusionnés (multipliés) pour former une nouvelle matrice de poids équivalente.
Exemple d'utilisation de BOFT
Pour un exemple d'application de la méthode BOFT à diverses tâches en aval, veuillez consulter les guides suivants :
Consultez les guides étape par étape suivants sur la façon d’affiner un modèle avec BOFT :
- Étude fine de Dreambooth avec BOFT
- Ajustement fin de la génération contrôlable avec BOFT (ControlNet)
Pour la tâche de classification d'images, on peut initialiser la configuration BOFT pour un modèle DinoV2 comme suit :
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
classe peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Paramètres
- boft_block_size (
int) — Taille des blocs de la matrice BOFT à travers les différentes couches, exprimée enint. Des tailles de blocs plus grandes entraînent des matrices de mise à jour plus denses, avec un plus grand nombre de paramètres entraînables. Choisissezboft_block_sizede manière à ce qu’il soit divisible par la dimension d’entrée de la plupart des couches (in_features), par exemple 4, 8, 16. Veuillez également ne spécifier queboft_block_sizeouboft_block_num, mais pas les deux simultanément, ni laisser les deux à 0, carboft_block_sizexboft_block_numdoit être égal à la dimension d’entrée de la couche. - boft_block_num (
int) — Nombre de blocs BOFT par couche injectée. Unboft_block_numplus grand entraîne des matrices de mise à jour plus creuses avec moins de paramètres entraînables. Notez que vous devez choisirboft_block_numde manière à ce qu’il soit divisible par la dimension d’entrée de la plupart des couches (in_features), par exemple 4, 8, 16. Spécifiez uniquementboft_block_sizeouboft_block_num, mais pas les deux simultanément, ni les laisser à 0, carboft_block_sizexboft_block_numdoit être égal à la dimension d’entrée de la couche. - boft_n_butterfly_factor (
int) — Nombre de facteurs de papillon à travers les différentes couches. Pourboft_n_butterfly_factor=1, BOFT est identique à l'OFT classique ; pourboft_n_butterfly_factor=2, la taille effective des blocs de l'OFT est doublée et le nombre de blocs est divisé par deux. - target_modules (
Union[List[str],str]) — Les noms des modules auxquels appliquer l’adaptateur. - exclude_modules (
Optional[Union[List[str], str]]) — Les noms des modules auxquels l’adaptateur ne doit pas être appliqué. Si une chaîne de caractères est transmise, une correspondance par expression régulière est effectuée. Si une liste de chaînes de caractères est transmise, une correspondance exacte est effectuée ou il est vérifié si le nom du module se termine par l’une des chaînes transmises. - boft_dropout (
float) — Probabilité de dropout multiplicatif, consistant à définir les blocs OFT comme l'identité pendant l'entraînement, de manière similaire à la couche de dropout dans LoRA. - fan_in_fan_out (
bool) — Définissez cette valeur sur True si la couche à remplacer stocke les poids sous la forme (fan_in, fan_out). Par exemple, gpt-2 utiliseConv1Dqui stocke les poids sous la forme (fan_in, fan_out) et il convient donc de définir cette valeur surTrue. - bias (
str) — Type de biais pour BOFT. Peut être ‘none’, ‘all’ ou ‘boft_only’. Si ‘all’ ou ‘boft_only’, les biais correspondants seront mis à jour pendant l’entraînement. Notez que cela signifie que, même en désactivant les adaptateurs, le modèle ne produira pas la même sortie que le modèle de base sans adaptation. - modules_to_save (
List[str]) — Liste des modules, à l'exception des couches BOFT, à définir comme entraînables et à enregistrer dans le point de contrôle final. - layers_to_transform (
Union[List[int],int]) — Les index des couches à transformer. Si cet argument est spécifié, les transformations BOFT sont appliquées aux index de couches indiqués dans cette liste. Si un seul entier est transmis, les transformations BOFT sont appliquées à la couche située à cet index. - layers_pattern (
Optional[Union[List[str], str]]) — Le nom du motif de couche, utilisé uniquement silayers_to_transformest différent deNoneet si le motif de couche ne figure pas dans les motifs de couches courants. Il doit cibler lenn.ModuleListdu modèle, souvent appelé'layers'ou'h'.
Ceci est la classe de configuration destinée à stocker la configuration d'un BOFTModel.
BOFTModel
classe peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Paramètres
- model (transformers.PreTrainedModel) — Le modèle à adapter.
- config (BOFTConfig) — La configuration du modèle BOFT.
- adapter_name (
str) — Le nom de l'adaptateur, par défaut"default". - low_cpu_mem_usage (
bool,optional, par défautFalse) — Crée des poids d'adaptateurs vides sur l'appareil méta. Utile pour accélérer le processus de chargement.
Retourne
torch.nn.Module
Le modèle BOFT.
Crée un modèle BOFT et OFT à partir d'un modèle transformers pré-entraîné. Article : https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Exemple :
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)
Attributs :
- model (transformers.PreTrainedModel) — Le modèle à adapter.
- peft_config (BOFTConfig) : La configuration du modèle BOFT.