
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT) é um método genérico projetado para o ajuste fino de modelos de fundação. Ele melhora a eficiência de parâmetros do paradigma de ajuste fino — Orthogonal Finetuning (OFT) —, inspirando-se na transformada rápida de Fourier de Cooley-Tukey, e apresenta resultados favoráveis ao ajustar diferentes modelos de fundação, incluindo grandes transformadores de visão, grandes modelos de linguagem e modelos de difusão de texto para imagem.
O resumo do artigo é:
Grandes modelos de fundação estão se tornando ubíquos, mas treiná-los do zero é proibitivamente caro. Assim, adaptar eficientemente esses modelos poderosos a tarefas de baixo nível é cada vez mais importante. Neste artigo, estudamos um paradigma de ajuste fino fundamentado — Orthogonal Finetuning (OFT) — para adaptação a tarefas de baixo nível. Apesar de demonstrar boa generalizabilidade, o OFT ainda utiliza um número bastante grande de parâmetros treináveis devido à alta dimensionalidade das matrizes ortogonais. Para abordar isso, começamos examinando o OFT sob a perspectiva de transmissão de informação e, em seguida, identificamos alguns requisitos-chave que permitem uma melhor eficiência de parâmetros. Inspirados em como o algoritmo de transformada rápida de Fourier de Cooley-Tukey permite uma transmissão de informação eficiente, propomos uma parametrização ortogonal eficiente usando estruturas de borboleta. Aplicamos essa parametrização ao OFT, criando um novo método de ajuste fino eficiente em parâmetros, chamado Orthogonal Butterfly (BOFT). Ao subsumir o OFT como um caso especial, o BOFT introduz um framework generalizado de ajuste fino ortogonal. Finalmente, conduzimos um estudo empírico extensivo da adaptação de grandes vision transformers, grandes modelos de linguagem e modelos de difusão de texto para imagem a diversas tarefas de baixo nível em visão e linguagem.
O BOFT foca em preservar as capacidades generativas de um modelo pré-treinado, sendo significativamente mais eficiente em parâmetros do que o OFT padrão. Assim como o OFT, o BOFT mantém a mesma similaridade cosseno (energia hipersférica) entre todos os pares de neurônios em uma camada ao aplicar uma transformação ortogonal à matriz de pesos pré-treinada, garantindo que as relações semânticas entre os neurônios sejam preservadas.
Em vez de usar uma matriz ortogonal bloco-diagonal, o BOFT fatora a transformação ortogonal em um produto de matrizes borboleta esparsas (originalmente introduzidas no FFT de Cooley–Tukey). Diferentemente das rotações bloco-diagonais do OFT, que misturam as entradas apenas dentro de cada bloco, a estrutura borboleta garante que cada entrada possa influenciar cada saída, produzindo uma conectividade densa com apenas O(d log d) parâmetros. Essa fatoração preserva a expressividade enquanto reduz drasticamente a contagem de parâmetros em comparação com o OFT (à custa do tempo de computação).
Na prática, o BOFT multiplica cada matriz de pesos pré-treinada por uma sequência de fatores ortogonais com estrutura de borboleta, permitindo rotações de neurônios eficientes e expressivas. Isso torna o BOFT adequado para geração controlável e para tarefas em que manter a representação do assunto do modelo pré-treinado é crítico, além de escalar para modelos maiores com menor sobrecarga de memória e computação.
O BOFT pode ser aplicado a qualquer subconjunto de matrizes de pesos em uma rede neural para reduzir o número de parâmetros treináveis. Dadas as camadas-alvo para a injeção dos parâmetros do BOFT, o número de parâmetros treináveis pode ser determinado com base no tamanho das matrizes de pesos.
Visão geral do benchmark
Mesclar os pesos do BOFT no modelo base
Assim como no LoRA, os pesos aprendidos pelo BOFT podem ser integrados às matrizes de pesos pré-treinadas usando a função [~BOFTModel.merge_and_unload(). Essa função mescla os pesos do adaptador com o modelo base, o que permite usar o modelo recém-mesclado de forma eficaz como um modelo independente.
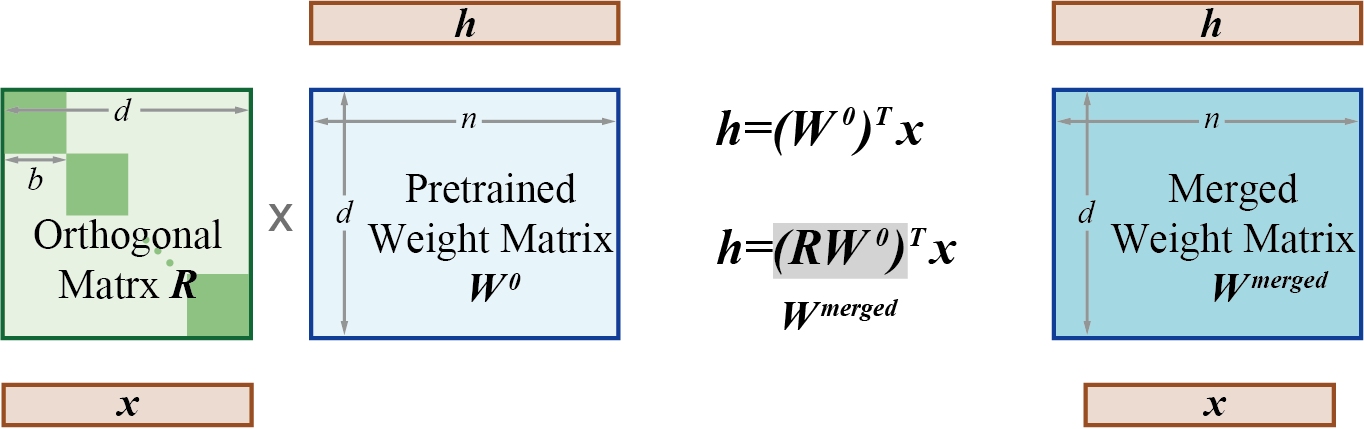
Isso funciona porque, durante o treinamento, a matriz de pesos ortogonal (R no diagrama acima) e as matrizes de pesos pré-treinadas são separadas. Mas, uma vez concluído o treinamento, esses pesos podem, na verdade, ser mesclados (multiplicados) em uma nova matriz de pesos equivalente.
Uso Exemplo do BOFT
Para um exemplo da aplicação do método BOFT em diversas tarefas downstream, consulte os seguintes guias:
Dê uma olhada nos seguintes guias passo a passo sobre como fazer o ajuste fino de um modelo com BOFT:
Para a tarefa de classificação de imagens, é possível inicializar a configuração BOFT para um modelo DinoV2 da seguinte forma:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
classe peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Parâmetros
- boft_block_size (
int) — Tamanho do bloco da matriz BOFT entre as diferentes camadas, expresso emint. Tamanhos de bloco maiores resultam em matrizes de atualização mais densas, com mais parâmetros treináveis. Escolhaboft_block_sizepara ser divisível pela dimensão de entrada da maioria das camadas (in_features), por exemplo, 4, 8, 16. Além disso, especifique apenasboft_block_sizeouboft_block_num, mas não ambos simultaneamente nem deixe ambos como 0, poisboft_block_sizexboft_block_numdeve ser igual à dimensão de entrada da camada. - boft_block_num (
int) — Número de blocos BOFT por camada injetada. Valores maiores deboft_block_numresultam em matrizes de atualização mais esparsas, com menos parâmetros treináveis. Nota: escolhaboft_block_numde forma que seja divisível pela dimensão de entrada da maioria das camadas (in_features), por exemplo, 4, 8, 16. Especifique apenasboft_block_sizeouboft_block_num, mas não ambos simultaneamente nem deixe ambos como 0, poisboft_block_sizexboft_block_numdeve ser igual à dimensão de entrada da camada. - boft_n_butterfly_factor (
int) — Número de fatores de borboleta entre as diferentes camadas. Paraboft_n_butterfly_factor=1, o BOFT é o mesmo que o OFT vanilla, paraboft_n_butterfly_factor=2, o tamanho efetivo do bloco do OFT fica duas vezes maior e o número de blocos é reduzido pela metade. - target_modules (
Union[List[str],str]) — Os nomes dos módulos aos quais o adaptador será aplicado. - exclude_modules (
Optional[Union[List[str], str]]) — Os nomes dos módulos para os quais o adaptador não deve ser aplicado. Ao passar uma string, será realizada uma correspondência por expressão regular. Ao passar uma lista de strings, será realizada uma correspondência exata ou será verificado se o nome do módulo termina com qualquer uma das strings passadas. - boft_dropout (
float) — A probabilidade de dropout multiplicativo, definida ao configurar os blocos OFT como identidade durante o treinamento, semelhante à camada de dropout no LoRA. - fan_in_fan_out (
bool) — Defina como True se a camada a ser substituída armazenar os pesos como (fan_in, fan_out). Por exemplo, o gpt-2 usaConv1D, que armazena os pesos como (fan_in, fan_out), e portanto este parâmetro deve ser definido comoTrue. - bias (
str) — Tipo de viés para BOFT. Pode ser ‘none’, ‘all’ ou ‘boft_only’. Se for ‘all’ ou ‘boft_only’, os vieses correspondentes serão atualizados durante o treinamento. Tenha em mente que isso significa que, mesmo ao desativar os adaptadores, o modelo não produzirá a mesma saída que o modelo base teria sem adaptação. - modules_to_save (
List[str]) —Lista de módulos, além das camadas BOFT, que devem ser configurados como treináveis e salvos no checkpoint final. - layers_to_transform (
Union[List[int],int]) — Os índices das camadas a serem transformadas. Se este argumento for especificado, as transformações BOFT serão aplicadas aos índices das camadas especificados nesta lista. Se um único inteiro for passado, as transformações BOFT serão aplicadas à camada neste índice. - layers_pattern (
Optional[Union[List[str], str]]) — O nome do padrão de camadas, usado apenas selayers_to_transformfor diferente deNonee se o padrão de camadas não estiver no padrão de camadas comum. Isso deve apontar para onn.ModuleListdo modelo, que frequentemente é chamado de'layers'ou'h'.
Esta é a classe de configuração para armazenar a configuração de um BOFTModel.
BOFTModel
classe peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Parâmetros
- model (transformers.PreTrainedModel) — O modelo a ser adaptado.
- config (BOFTConfig) — A configuração do modelo BOFT.
- adapter_name (
str) — O nome do adaptador, padrão é"default". - low_cpu_mem_usage (
bool,optional, defaults toFalse) — Cria pesos de adaptador vazios no dispositivo meta. Útil para acelerar o processo de carregamento.
Retorna
torch.nn.Module
O modelo BOFT.
Cria um modelo BOFT e OFT a partir de um modelo transformers pré-treinado. Artigo: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Exemplo:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)Atributos:
- model (transformers.PreTrainedModel) — O modelo a ser adaptado.
- peft_config (BOFTConfig): A configuração do modelo BOFT.