
Hub documentation
上传数据集
上传数据集
Hub 汇集了海量的社区精选和研究数据集。我们鼓励您将数据集分享到 Hub,以助力机器学习社区的发展,并加速所有人的研究进程。我们欢迎所有贡献;添加数据集只需拖放即可!
如果还没有,请先创建一个 Hugging Face Hub 账户。
使用 Hub UI 上传
Hub 的基于 Web 的界面允许没有任何开发经验的用户上传数据集。
创建仓库
仓库托管了您的所有数据集文件,包括修订历史记录,因此可以存储多个数据集版本。
- 点击您的个人资料,然后选择 New Dataset 以创建 新的数据集仓库。
- 为你的数据集选择一个名称,并选择它是公开数据集还是私有数据集。公开数据集对所有人可见,而私有数据集只能由你或你所在组织的成员查看。

上传数据集
- 创建仓库后,前往 Files and versions 选项卡以添加文件。选择 Add file 来上传你的数据集文件。我们支持许多文本、音频、图像及其他数据扩展名,例如
.csv、.mp3和.jpg(请参阅完整的 File formats 列表)。
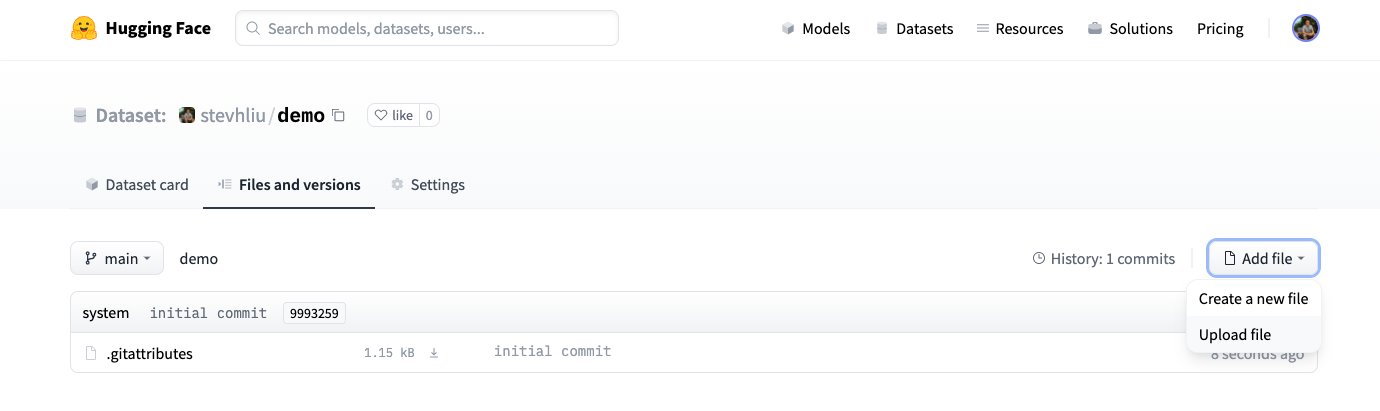
- 拖放您的数据集文件。

- 上传数据集文件后,它们将存储在你的数据集仓库中。

创建数据集卡片
添加数据集卡片对于帮助用户找到您的数据集并了解如何负责任地使用它非常有价值。
- 点击 创建数据集卡片 以创建一个 数据集卡片。此按钮会在你的仓库中创建一个
README.md文件。

在顶部,您会看到元数据 UI,其中包含多个可供选择的字段,例如许可证、语言和任务类别。这些是帮助用户在 Hub 上发现您的数据集(如适用)最重要的标签。当您为某个字段选择一个选项时,该选项会自动添加到数据集卡片的顶部。
您还可以查看 Dataset Card 规范,其中包含一组完整的允许标签,包括诸如
annotations_creators之类的可选标签,以帮助您选择对数据集有用的标签。
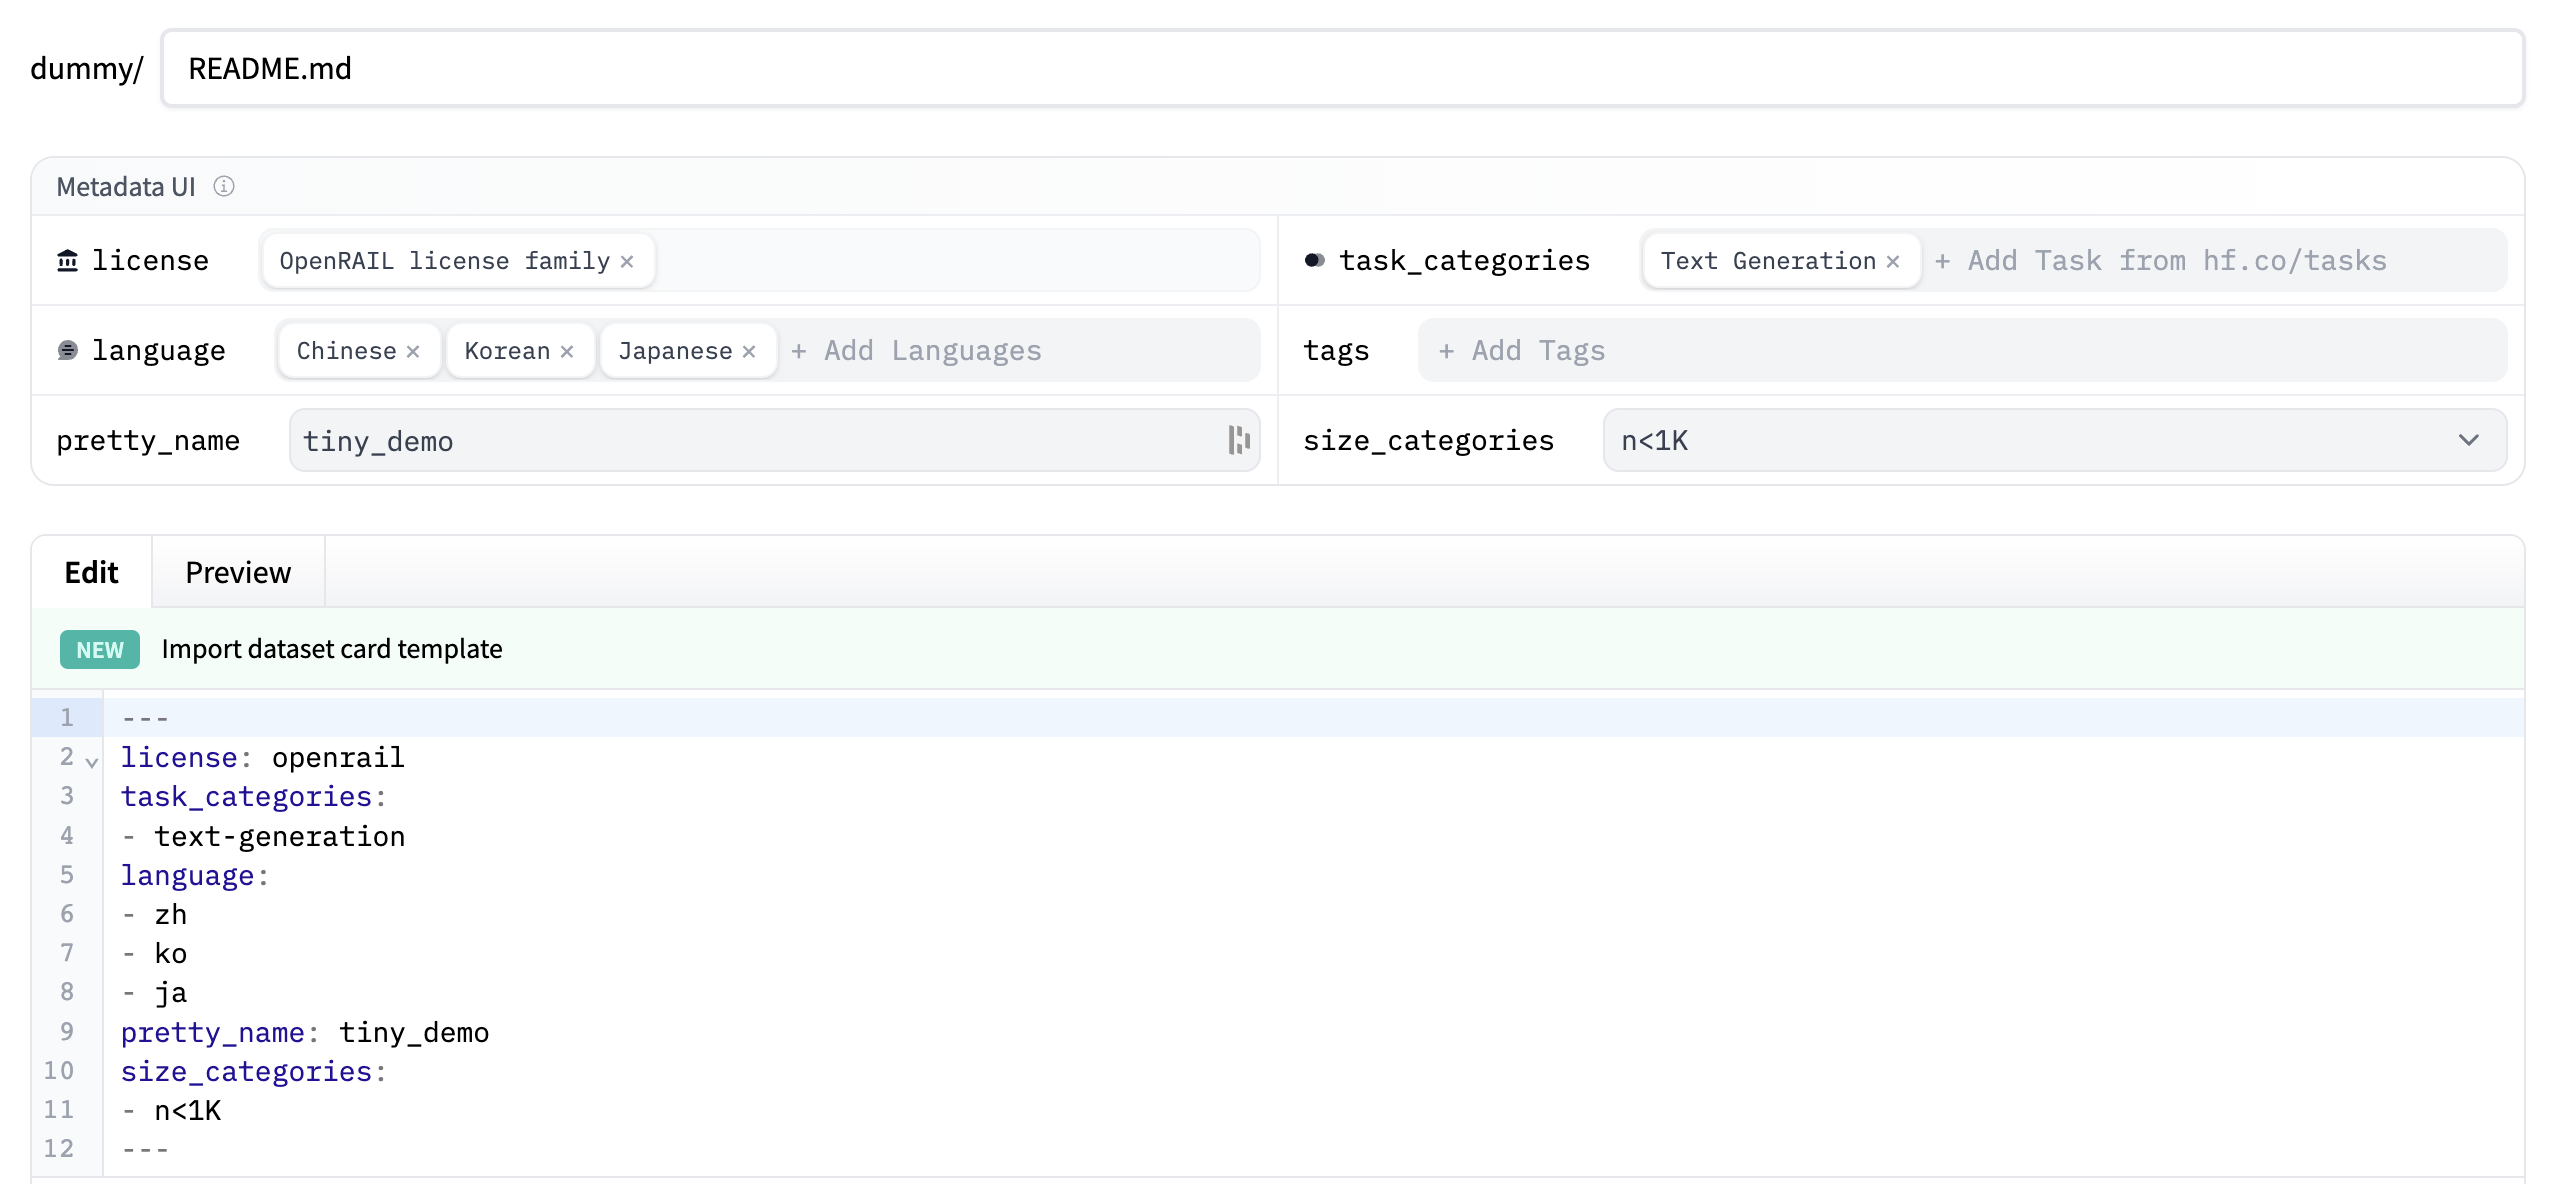
在数据集卡片中撰写数据集文档,向社区介绍您的数据集,并帮助用户了解其内容:包括用例和局限性、数据来源、重要的伦理考量以及其他相关细节。
您可以点击编辑器顶部的 Import dataset card template 链接,自动创建数据集卡片模板。如需查看优秀数据集卡片的详细示例,请参阅 CNN DailyMail Dataset card。
使用 huggingface_hub 客户端库
huggingface_hub 库功能丰富,可帮助您管理仓库,包括创建仓库以及向 Hub 上传数据集。请访问 客户端库文档 以了解更多信息。
使用其他库
一些库,例如 🤗 Datasets、Pandas、Polars、Dask、DuckDB 或 Daft,可以将文件上传到 Hub。 有关更多信息,请参阅 Datasets Hub 支持的库列表。
使用 Git
由于数据集仓库是 Git 仓库,您可以使用 Git 将数据文件推送到 Hub。请遵循仓库入门指南,了解如何使用git CLI 提交并推送您的数据集。
摄取数据集
如果您的数据存储在数据库、云存储中,或位于 API 之后,您可以将其摄取到 Hugging Face,作为可直接使用的数据集。
有关摄取数据集的更多信息,请参阅摄取数据集文档。
文件格式
Hub 原生支持多种文件格式:
- Parquet(.parquet)
- CSV(.csv、.tsv)
- JSON Lines,JSON(.jsonl、.json)
- Arrow 流式和 IPC 格式(.arrow)
- 文本(.txt)
- 图像(.png、.jpg 等)
- 音频(.wav、.mp3 等)
- 视频(.mp4、.mov、.avi 等)
- PDF(.pdf)
- WebDataset(.tar)
- Lance(.lance)
它支持使用 ZIP (.zip)、GZIP (.gz)、ZSTD (.zst)、BZ2 (.bz2)、LZ4 (.lz4) 和 LZMA (.xz) 压缩的文件。
图像和音频文件也可以拥有额外的元数据文件。请参阅有关图像和音频数据集的 数据文件配置,以及 CSV、TSV 和图像的 示例数据集 集合。
您可能希望将文件转换为这些格式,以充分利用 Hub 的所有功能。 其他格式和结构可能无法被 Hub 识别。
我应该使用哪种文件格式?
对于大多数类型的数据集,由于 Parquet 具有高效的压缩能力、丰富的类型支持,且众多工具都支持该格式并提供了优化的读取和批处理操作,因此它是推荐的格式。或者,对于表格数据可以使用 CSV 或 JSON Lines/JSON(对于嵌套数据,建议优先使用 JSON Lines)。虽然与 Parquet 相比这些格式更容易解析,但不建议用于大于数 GB 的数据。对于图像和音频数据集,在大多数使用场景中,上传原始文件是最实用的,因为这样可以轻松访问单个文件。对于大规模图像和音频数据集的流式处理,应优先选择 WebDataset 而非原始图像和音频文件,以避免访问单个文件带来的开销。不过,对于涉及分析、数据过滤或元数据解析等更通用的使用场景,Parquet 是大规模图像和音频数据集的推荐选项。
Data Studio
在下载数据之前,Data Studio 有助于了解数据的实际样貌。 它默认对所有公开数据集启用。对于由 PRO 用户 或 团队或企业组织 拥有的私有数据集,也可使用该功能。
上传数据集后,请确保数据集查看器正确显示了您的数据,或者配置数据集查看器。
大规模数据集
Hugging Face Hub 支持大规模数据集,通常以 Parquet(例如通过 🤗 Datasets 使用 push_to_hub() 上传)或 WebDataset 格式上传。
使用 huggingface_hub 库中的 upload_folder() 或 hf upload 来上传大型文件夹:它们会将上传拆分为多个提交,并在中断后自动恢复。
请参阅如何上传大型文件夹、大型上传的技巧与窍门以及仓库存储限制与建议。
Update on GitHub